AWS re:Invent 2025 - Databases 数据库相关的分组讨论
持续更新中
AWS re:Invent 2025 Databases breakout sessions - YouTube playlist,总共有 37 场,有一些和 AI 相关,挑选一些了对自己有帮助的(大部分都感兴趣,利用早上和白天的空闲,都看了,看了还简单做了些笔记)。
AWS 数据库主要涉及:RDS(包括 Aurora RDS),Aurora DSQL(分布式数据库),DynamoDB,DocumentDB,ElastiCache(Valkey 是主要方向),和 Neptune 等,其他的,比如:Redshift、时序数据库也不能作为主要方向。
RDS 和 Aurora DSQL
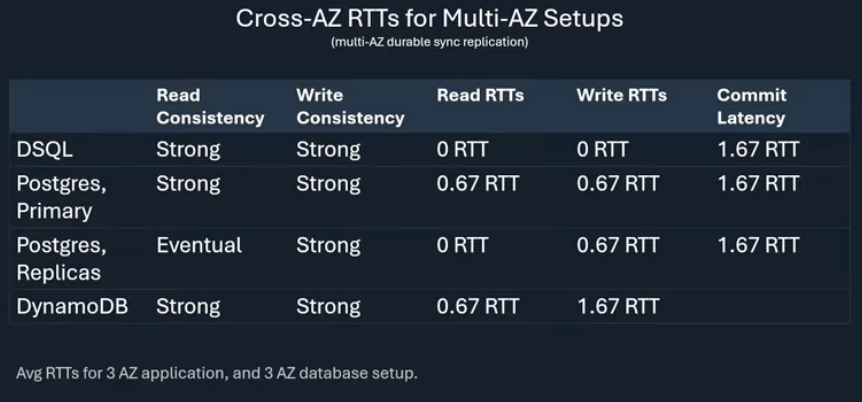
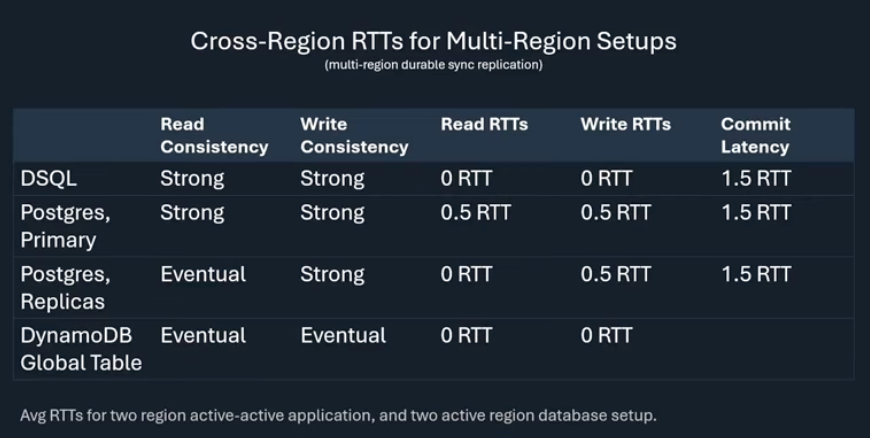
AWS re:Invent 2025 - A tale of two transactions (DAT455)
Marc Brooker 聊的一个话题,下面两张图是其主要想聊的内容,前面部分其实聊的有点无聊。
AWS re:Invent 2025 - Amazon Aurora HA and DR design patterns for global resilience (DAT442)
AWS re:Invent 2025 - Deep dive into Amazon Aurora DSQL and its architecture (DAT439)
同一个人 Marc Bowes 参与了这两个 session;Aurora RDS 和 Aurora DSQL 是不同的设计,前者和 AWS RDS 也是不同的设计,主要体现在存储层;DSQL 是 NewSQL 分布式数据库非传统 SQL 数据库,可以实现强一致的多活读写。
Aurora RDS 应该是 AWS 持续投入的方向,DSQL 不一定有多少用户需要它(结合 2024 年阿里数据库研发同学写的文章看看 DSQL 的设计 https://baotiao.github.io/2024/12/15/aurora-2024-1.html)。
AWS re:Invent 2025 - Boost performance and reduce costs in Amazon Aurora and Amazon RDS (DAT312)
这个 session 不错,从计算、存储和备份以及 I/O 如何优化成本,通过选择合适的服务和类型,以及架构的调整。
AWS re:Invent 2025 - Revealing the northern lights: Amazon Aurora security deep dive (DAT456)
关于 Aurora 的安全机制。
AWS re:Invent 2025 - Deep dive into Amazon Aurora and its innovations (DAT441)
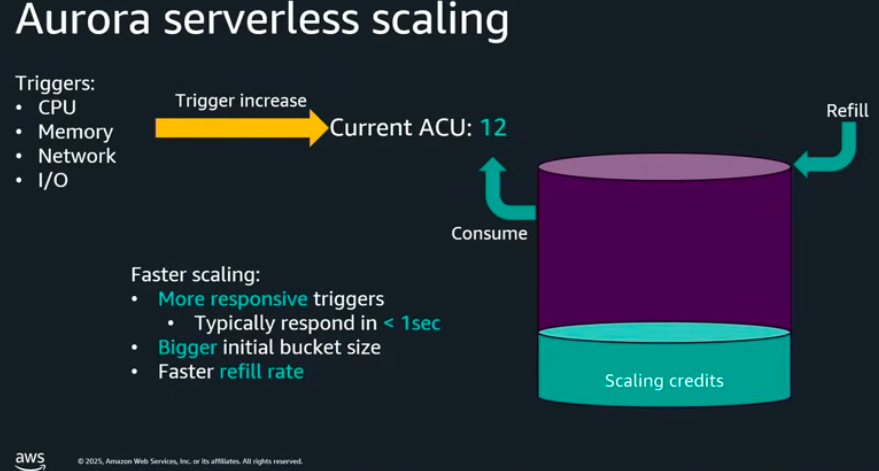
Aurora 的架构,也特别聊了 Aurora Serverless 的细节包括 scaling 的性能,如何升级打补丁,性能上优化,最后聊了 DSQL,非常好的一个 session。
AWS re:Invent 2025 - PostgreSQL performance: Real-world workload tuning (DAT410)
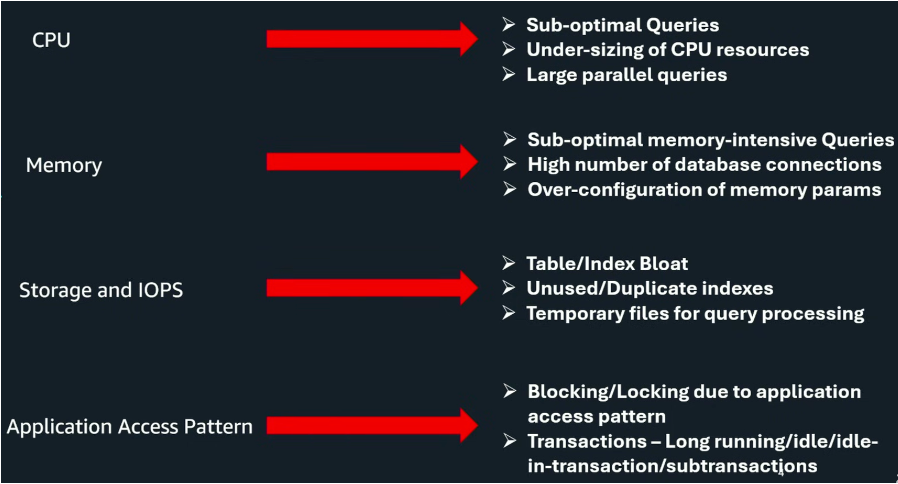
有关于 PostgreSQL 性能调优。
AWS re:Invent 2025 - Binge-worthy: Netflix's journey to Amazon Aurora at scale (DAT322)
如何第三方 PG 迁移到 Aurora PG,从迁移设计、工具开发、验证和切割展开,不错的参考(Netflix 也发了个博客文章 - Automating RDS Postgres to Aurora Postgres Migration | by Netflix Technology Blog | Feb, 2026 | Netflix TechBlog,文章里面有更详细的信息,也提到了上面 session 没提到的一些内容)。
AWS re:Invent 2025 - Amazon Aurora DSQL: A developer's perspective (DAT401)
开发者视角如何使用 DSQL,强一致,OCC 机制下需要处理事务冲突的异常。
DynamoDB
AWS re:Invent 2025 - DynamoDB: Resilience & lessons from the Oct 2025 service disruption (DAT453)
https://www.youtube.com/watch?v=YZUNNzLDWb8&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=8
2025 AWS 美东事故的剖析。
AWS re:Invent 2025 - How Samsung optimized 1.2 PB on Amazon DynamoDB with zero downtime (DAT323)
三星云的实际优化案例。
AWS re:Invent 2025 - Multi-Region strong consistency with Amazon DynamoDB global tables (DAT440)
MRSC vs. MREC 跨区域强一致性和最终一致性。
AWS re:Invent 2025 - Dive deep into Amazon DynamoDB (DAT435)
实际案例出发,讲的挺好,但是对我来说还是经验不够,理解不足,比如:第一个案例,hash 问题导致分区不工作。
AWS re:Invent 2025 - Advanced data modeling with Amazon DynamoDB (DAT414)
AWS re:Invent 2025 - Data modeling core concepts for Amazon DynamoDB (DAT311)
挺深入的,关于如何建模(不太懂 DynamoDB,为什么叫建模,而不是表的设计?),PK/SK (sort key)和 LSI/GSI(local second index,global second index) 等等等设计,以及可用性和增量备份,和 OpenSearch 等的集成,实际例子挺深入的,不错的 session。
DocumentDB
AWS re:Invent 2025 - Supercharge app intelligence using gen AI with Amazon DocumentDB (DAT313)
还是关于向量化存储和检索。
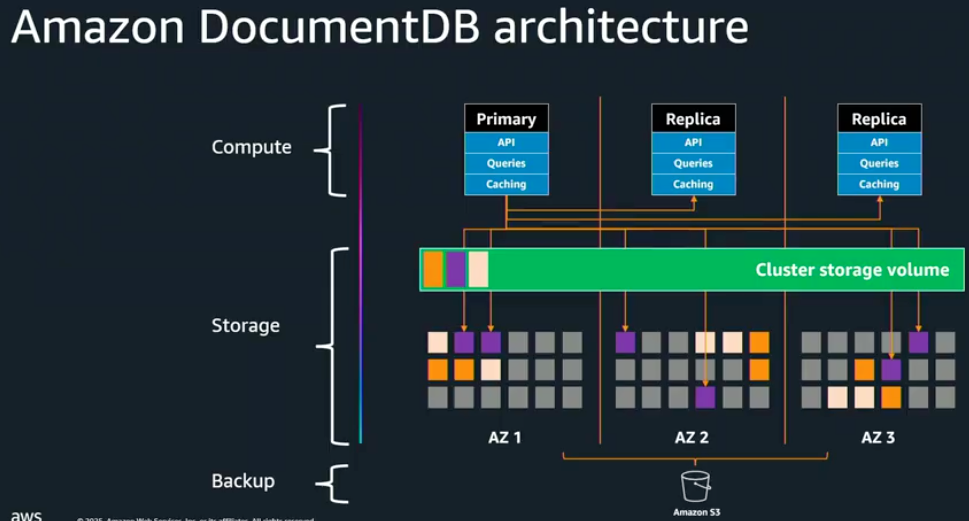
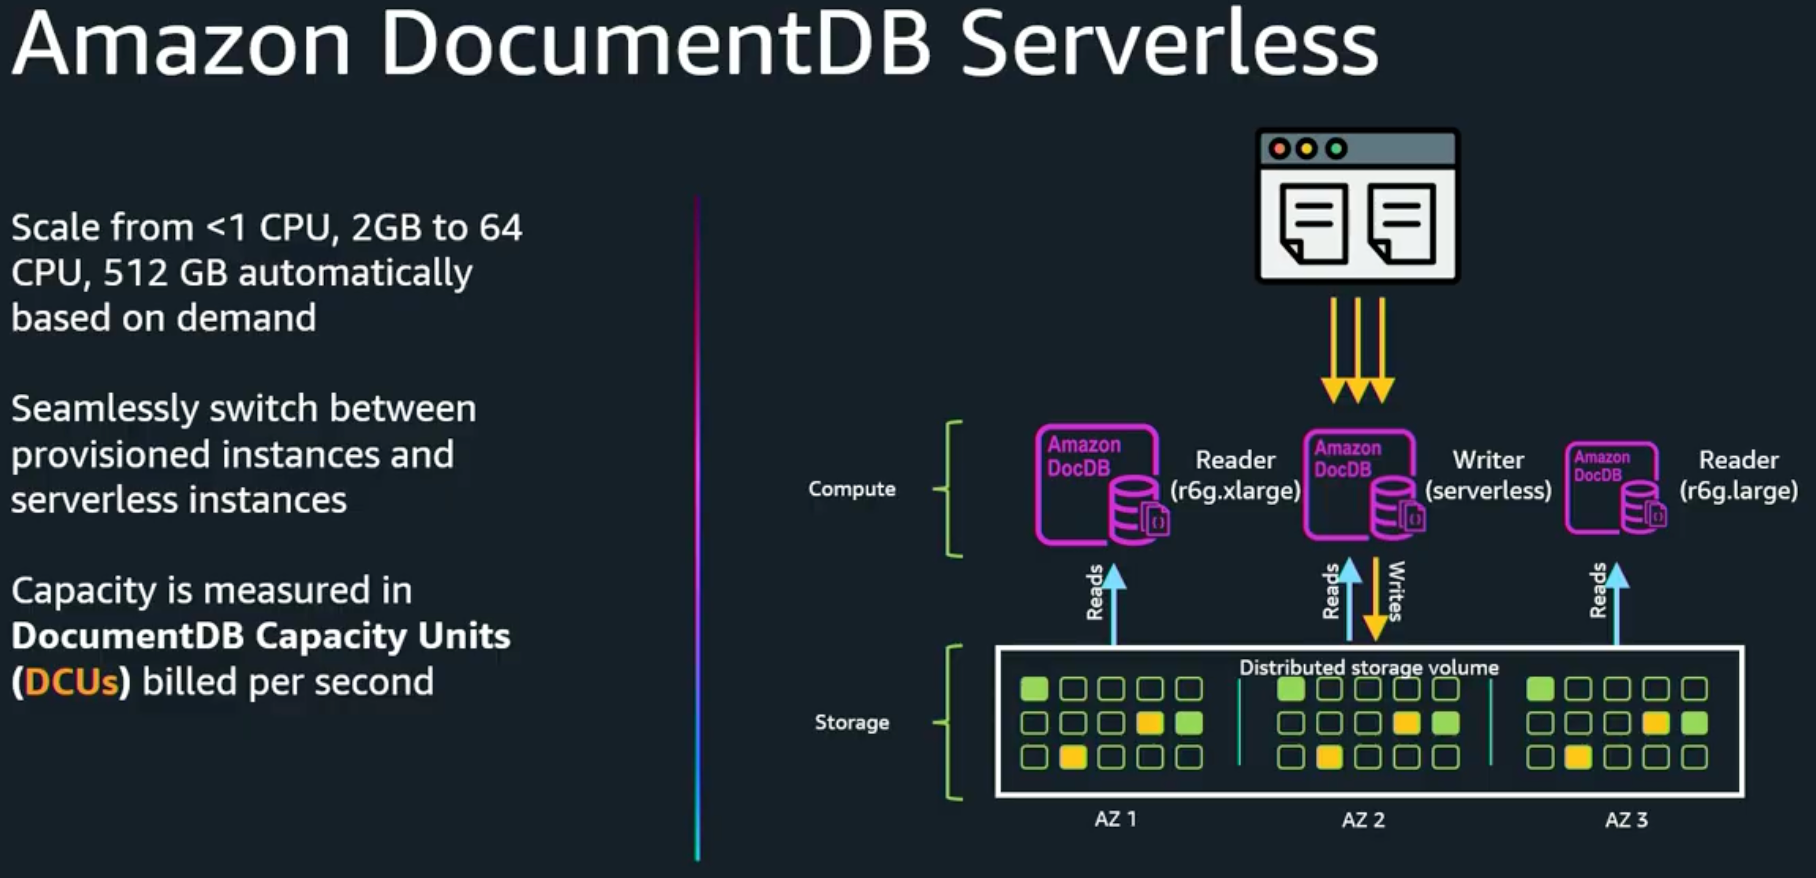
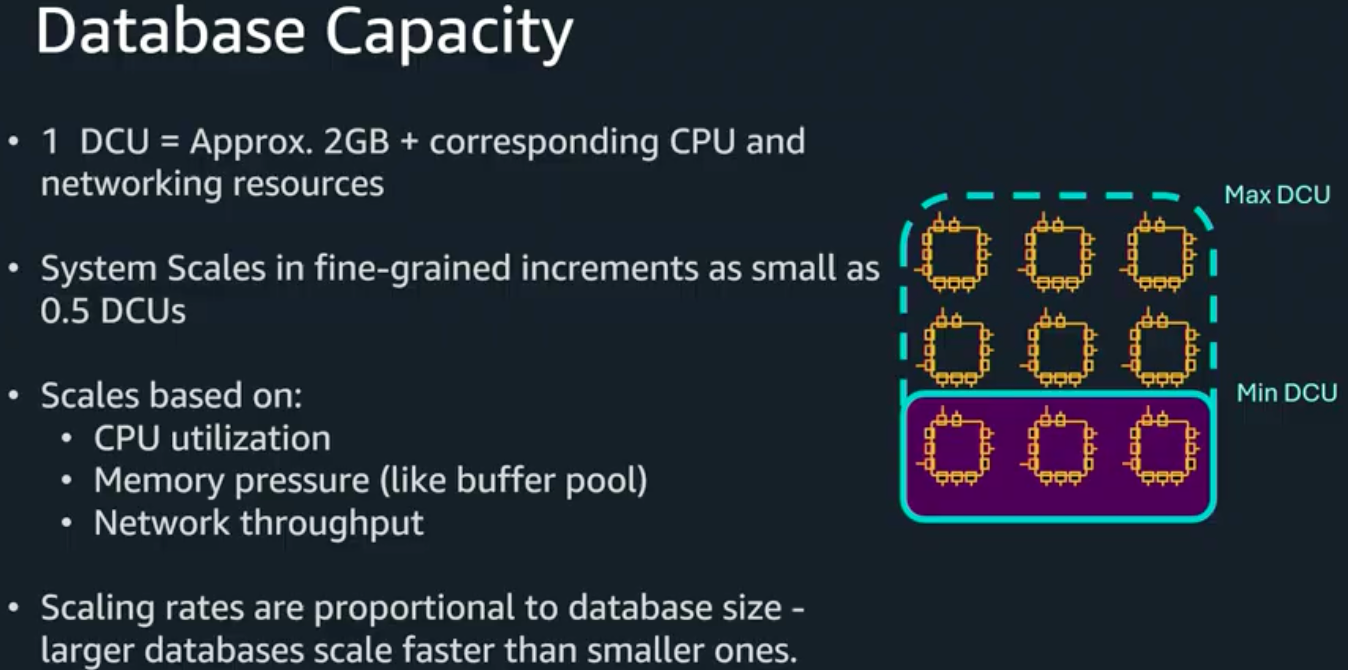
AWS re:Invent 2025 - Deep dive into Amazon DocumentDB and its innovations (DAT444)
深入 DocumentDB 架构,特性,DocumentDB Servless 架构,深入了解 DocumentDB 的一个起点。
ElastiCache Valkey
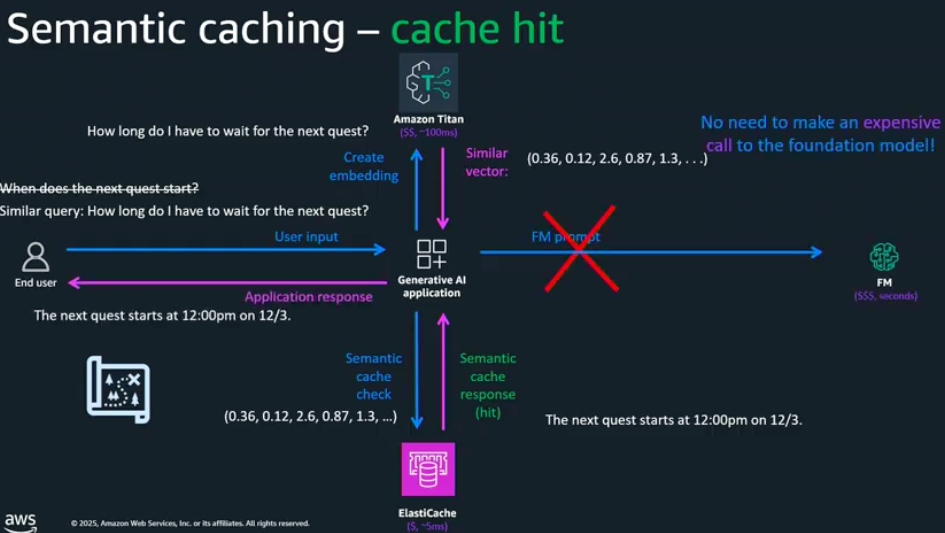
AWS re:Invent 2025 - Optimize agentic AI apps with semantic caching in Amazon ElastiCache (DAT451)
如何实现语义缓存和匹配,通过向量化存储和搜索。
[AWS re:Invent 2025 - Video sampling & search using ElastiCache & multimodal embeddings (DAT433)](https://www.youtube.com/watch?v=3Kbv_BI3NJ0&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=4]
对于视屏帧数据的多模态处理,Valkey 向量存储和检索。
AWS re:Invent 2025 - Advanced data modeling for Amazon ElastiCache (DAT438)
印象深刻的还是和 Valkey 如何存储向量和检索,semantic cacheing。
AWS re:Invent 2025 - Better, faster, cheaper: How Valkey is revolutionizing caching (DAT458)
撇开内容本身,看到的时候我在想作为 Director of Product Management 还能在台上游刃有余的讲产品和技术,并有足够的深度,这是我们需要学习的地方,一个技术公司需要这样。
Technical steering committee 有不少都是国人,也算厉害了;Valkey 是 Redis fork 出来的并开源了的。
聊了多线程架构
- 给了一个火焰图分析,read/write command,特别是 write command 是栈最深的
- main + IO thread 1, 2, ..., n: “While the core execution remains on a single thread to preserve data consistency, parsing commands and writing responses are offloaded to IO threads”
存储和性能优化
最后是关于Roadmap - 未来会支持时序类型;不错的一个 session,有深入的内容。
[AWS re:Invent 2025 - Optimizing for high performance with Amazon ElastiCache Serverless (DAT437))(https://www.youtube.com/watch?v=fXB6wftmigU&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=34)
性能优化方面的。
Neptune
AWS re:Invent 2025 - Using graphs over your data lake to power generative AI applications (DAT447)
图数据库在 AI 时代越发重要了,如何结合数据湖,向量搜索、图 RAG 和记忆相关性。
其他 session
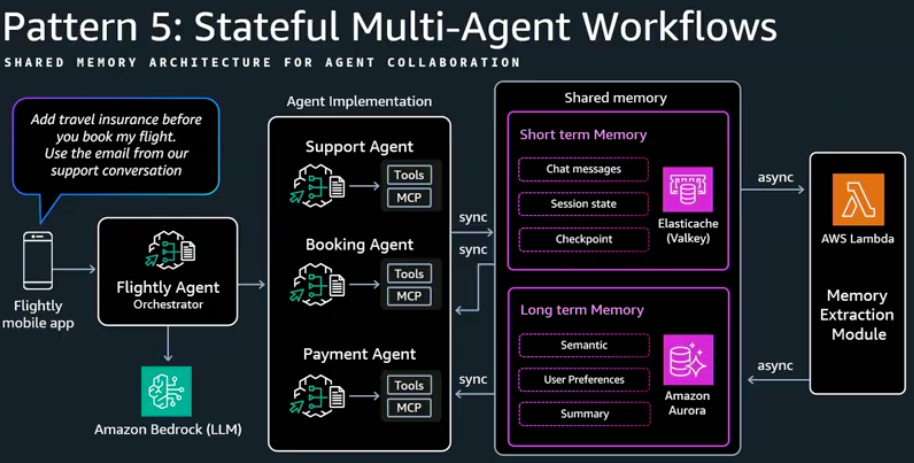
AWS re:Invent 2025 - Build serverless chatbots using Amazon ElastiCache & Aurora PostgreSQL (DAT314)
最后部分聊的 pattern,挺好的,短期和长期记忆分别存储于 Valkey 和 PG。
小结
总的来说,AWS 在数据库方向除了分析型数湖仓和时序数据库方向之外,都有完整的布局和持续的投入,而且基本都提供 Serverless 选项,计费来说都是从软硬件结合为统一单位来看。
评论已关闭