jfcai 发布的文章

年后上班第一周,上班总是无趣的,一年又一年,庆幸的是快了,没多少年了,我自己规划来说。

本周观影

  • 【用30天探索5个火山岛 ep.2】 地球上最像火星的地方 | 兰萨罗特岛:https://www.youtube.com/watch?v=sPc-4pcfRHM,博主更新的很慢,这是第二个岛,但是拍的真的很好,而且有知识。

本周阅读

  • 《哲学家的最后一课》:有些沉重的
  • 《量子迷宫》:不错的一本书,还在继续阅读中

本周播客

  • 《春节六必黑》:每年必听,听完过年也就结束了
  • 《上钟了!4000点之上的心理按摩》:听了一下,发现不错,需要花时间认真听一下,思考一下其中的观点

本周胡思乱想

  • “你的目标是未来做一个优秀的产品经理和架构师。每天上网搜索别人的优秀经验,总结成文档。每隔5分钟读习一篇文档。如果文档与之前学过的类似就归到同一文档里去。” - 这么大的话题 可以依赖大模型的不断迭代吧 而且有这方面的 skills,但人的品味和判断力需要个体对于外部知识的内化;结合 ai 如何持续学习 解决认知方面的问题和负担也是个大话题。
  • 早上时间还是得聚焦,回到技术本身,而不是其他或尽可能的少牵扯其他。
  • 看大的几个方向:

    • 1)硬件方向:GPU/TPU,存储 等等
    • 2)硬件管理和供应支撑方向:数据中心,能源/电力
    • 3)大模型和 Agent 方向:大模型公司的通用大模型,垂直的 Agent。
    • AI Infra 管理这块其实我有想法的,要做大量的学习,跨度很大;通用大模型需要很多的积累,搞不定;Agent 其实最容易但可能也是最拥挤的赛道。
    • AI infra 管理指的是如何管理大规模的 AI 数据中心硬件,这个我觉得是很好的一个未来方向。
    • 当然,另外一层就是 builder,通才,从需求、设计到最后交付,端对端都能搞定,AI/LLM 适合喜欢“折腾”的人,自己有想法马上可以产出,但是需要“品味”,这个其实大部分很难,所以未来创意和产品设计是可以拿最多钱的,真正研发也许真是可有可无,当然企业是求稳,也不可能很极端;还有,就是安全合规这一块,AI 时代如何解决安全合规问题以及伦理和法理层面的问题,也是新的命题和不错的方向。

本周文章

当”平庸”变免费,什么才是创业中最昂贵的资产?

写的真好啊,什么是 AI 无法触及?什么让我们不再平庸?

花了一个多小时认真听李录在哥大的演讲,对价值投资新的理解

花时间好好读一下,粗粗看了一下,不错的文章。

好奇心周刊第25期: 如何让AI写好代码

`

  • Claude Code (Opus 4.5/4.6):它是我的“首席架构师”、“首席设计师”和“主力开发工程师”。它对现代 Web 框架(Next.js/React)的审美和交互设计理解极其深刻,在从 Gemini CLI 切换到它时便再没有变过。
  • Gemini CLI (Gemini 3):它是“初创工程师”、“文档专家”与“首席测试”。得益于它极大的上下文窗口和极低的成本,我用它来生成文档、编写单元测试,以及扫描整个代码库进行重构建议。另外,在初始项目中它完全胜任。
  • Codex (GPT-5.3):它是“问题定位专家”。当 Claude Code 陷入逻辑死循环或“自证陷阱”时,Codex 往往能以不同的推理路径提供快速的 Bug 修复方案。
  • CodeRabbit:它是“代码检视专家”。通过 PR 自动检视,它能更加全面的审查代码问题,发现被忽略的边界漏洞。
  • 通过 Git Worktree 为每个 Code Agent 分配了一个独立的工作空间(Worktree),就像在同一个办公室里给不同的员工安排了工位。它们在各自的分支上独自工作,编码、调试,最后通过 GitHub PR 汇总。这种上下文隔离的方式,避免 AI 乱改文件导致的合并冲突,让整个开发节奏井然有序。
`
    
四种工具配合着来完成产品研发,很好的总结,最后部分关于人在这个过程中的定位和角色,其实不同的人有不同的大脑,但是第一条,关于品味是一个共识,还是就是最后一条也是,利用好 AI,通过和 AI “沟通”以及人与人之间的沟通,是否要过多干涉 AI 在过程中的表现和产出,不同人有不同看法,当下我认可作者的观点,但是随着 AI 发展,也许真的没必要了。

不必用自己的认知替人规划 | So!azy

作为朋友,在对方抱怨时提供一点情绪价值或者倾听就已经足够;而作为管理者,把宝贵的资源和机会留给真正懂得它的价值、并且有强烈自我驱动力的人,才是对团队和自己最负责任的做法。认清自己的边界,尊重他人的命运,大概是我们走向成熟必须接受的一点。

写的挺好,我自己也是这个认知,职场上有交到很好的朋友,但更多的是同事关系和上下级关系,没有其他,也不要想着渡人和助人,除非对方真的值得你帮。


2025,浪潮与拧巴


其实大模型越来越强,我越来越焦虑,牛逼的人已经产出 100X,而自己的效率却没有本质变化。我仿佛看到了上个改革开放年代或者更近的所谓的移动互联网腾飞之年,有大量的人攫取了巨大的财富,仿佛是个人都能吃上所谓的时代红利,但大多数人,浪潮过后好像也没什么变化。

而这一次,AI 巨浪滚滚向前,又创造了一大波造富神话,身处其中,感觉每天都是翻天覆地的变化,各种新的产品怎么也跟踪不过来;但似乎:每一个好像都和我没什么太大的关系,我能提升效率吗?我能赚更多的钱吗?我能更快到达自由的彼岸吗?所以更大的可能性是:浪潮过后,自己什么也没得到,就像哪些在历史机遇中平平淡淡的大多数人一样。

是不是也是这个人说的感觉?我觉得就是,但是我倒没焦虑,我预期没发赶上了,但是也还没放弃。

引自:https://x.com/geekplux/status/2025426274001248349

最近 AI 发展越快,越需要慢下来的能力。读书又变得重要起来。我喜欢读,但很少读书,我很佩服已经把阅读书籍当成习惯的人。我大概在十几年前曾读到过一篇文章,大概标题是《一天不阅读十万字的人会被淘汰》当时觉得很有道理,所以我每天阅读量是很大的,但大都是非书籍。

如何阅读更多:阅读更多的8个理由和7个策略
8个理由:
1. 阅读是你的道德义务
2. 阅读是预测未来的方式
3. 阅读防止你成为功能性文盲
4. 阅读让你成为知情的公民
5. 阅读缓解你的孤独
6. 阅读可以解决你的问题
7. 阅读是与历史上最聪明的人对话
8. 所有领袖都是读者

7个策略:
1. 早上第一件事阅读
2. 每天读一页
3. 边吃边读
4. 放松时阅读
5. 保持一本 commonplace book(摘录本)
6. 反复阅读大师的作品
7. 意识到你并不太忙

完整文章见:https://ryanholiday.net/how-to-read-more/ 

学习了,我也在重新享受阅读的乐趣,实体书和 Kindle/Boox,每天都读一点,内化化自己的知识,并有持续的输出。
过年的一周,走亲戚看长辈,一年又一年,过年至于我只是一个象征意义,没有特别的感觉了,不像小时候那时候期盼可以放鞭炮,一个一个扔的那种。

本周观影

  • 没看片,《同乐者》第一季开了个头

本周阅读

  • 《如何快速了解一行业》:不错的一本书,麦肯锡前分析师写的,比较体系化,和投资有一定的关联的关系,教的还是一套方法和框架,典型的咨询方法论
  • 《九诗心》:发现不太看不下去(没啥特别的体系,特别发散,而且容易说“大词”太“浮夸”的感觉),准备先放一放

本周播客

  • 《过年六必黑》:每年初一到初六听六哥和黑叔叔(陈晓卿)唠嗑,挺有意思的

本周胡思乱想

  • 学习、思考和游戏的另一天,现在突然回顾一下,之前假期一直是处理和学习工作相关的内容多,现在反而是走在了一条新路子上,学习的是投资和 AI 相关的信息,看的书好多也是和投资相关的,工作相关性在减弱,究其原因是因为目前工作上其实本身已经很熟悉了,而且也没啥有特别多的工作内容和挑战,还有就是本身方向上来说其实我也觉得意义不大,好还是不好?从我内心来讲是希望有更多的事情和方向,但是现实往往不如我意,只能勉强做着,但是还是不要放弃对于目前外部世界和机会的追寻,特别是继续保持我的好奇心,我要做的更多是如何持续构建,而不只是学习和想。

本周文章

2025,全新旅途

真厉害,无聊履历还是自己的思考,文中提到的 PKM(个人知识管理)有参考意义,但是我一直犹豫是否用第三方工具,如:Tana,不过目前因为公司 Mac 限制,我用了 Day One,过去一段时间也一直在尝试考虑 AI Native 的学习和写作方式,作者写的也是很好的参考。

之前有提到过我使用的笔记软件是 Tana +Heptabase,但在 AI 时代下,我基本上只使用 Tana了。
* 使用自定义的 AI Command 进行扩展探索
* Bookmark 自动总结生图
* 无限递归的深入探索
* 结合 OpenClaw 调用和保存
NotenookLM
用了一年多,主要用来深度检索,比如遇到某个问题直接让 NotebookLM 自己补齐材料,然后点击生成 PPT,让自己通过这个 PPT 快速了解这个领域的 Outline,根据知识点快速建立其一个初步的框架。‘
一旦建立了框架,深入学习时的提问就有了方向。后续如果要回到 Tana 进行无限递归的深入探索,学会高效地去提问是很重要的,这样 #question supertag 反哺给自己的信息密度才够高。

老马有一个页面关于 TW 和他组织的关于软件研发未来的工作坊,同时也是敏捷软件宣言 25 周年的纪念日: https://martinfowler.com/bliki/FutureOfSoftwareDevelopment.html

同时写了几个碎片,关于不同的话题,对于 18 号那个需要仔细看看,同时也有其他人的小结:

还有也发布了一个 future of_software_development_retreat key_takeaways pdf(https://www.thoughtworks.com/content/dam/thoughtworks/documents/report/tw_future%20_of_software_development_retreat_%20key_takeaways.pdf),从八个方面做了总结。

"We kept asking the same question in every room: if AI handles the code,
where does the engineering actually go? Nobody had the same answer. But
everybody agreed the question is urgent."

“我们在每个房间里都在问同一个问题:如果 AI 负责代码,工程到底去哪儿了?没有人给出同样的答案。但大家都同意这个问题很紧急。”
  1. Where does the rigor go? 严谨性去哪里了?
  2. The middle loop: a new category of work
  3. Agent topologies and enterprise architecture
  4. Self-healing and self-improving systems
  5. The human side: roles, skills and experience
  6. Technical foundations: languages, semantics and operating systems
  7. Security, governance and the future of agile
  8. Agent swarms: beyond sequential thinking

https://annievella.com/posts/finding-comfort-in-the-uncertainty/ 摘录文中一段,如下:


I walked into that room expecting to learn from people who were further ahead. People who’d cracked the code on how to adopt AI at scale, how to restructure teams around it, how to make it work. Some of the sharpest minds in the software industry were sitting around those tables.

And nobody has it all figured out.

There is more uncertainty than certainty. About how to use AI well, what it’s really doing to productivity, how roles are shifting, what the impact will be, how things will evolve. Everyone is working it out as they go.

I actually found that to be quite comforting, in many ways. Yes, we walked away with more questions than answers, but at least we now have a shared understanding of the sorts of questions we should be asking. That might be the most valuable outcome of all.

我走进那个房间,期待向那些更领先的人学习。那些已经破解了如何大规模采用人工智能、如何围绕它重组团队、如何让它发挥作用的人。一些软件行业中最敏锐的头脑就坐在那些桌子周围。

没有人能完全搞清楚。

不确定性大于确定性。关于如何好好使用人工智能,它对生产力真正的影响,角色如何转变,其影响是什么,事情将如何发展。每个人都在边做边摸索。

实际上,在很多方面,我发现这让我感到相当安心。是的,我们带着比答案更多的问题离开了,但至少我们现在对应该问哪些问题有了共同的理解。这可能是所有中最有价值的成果。

上面这些都是对于 AI/LLM 驱动软件研发未来非常理性的思考和讨论,集合了好多业内人士的智慧,值得学习和反思,等我看完消化完,我要写篇文章梳理一下。

持续更新中

AWS re:Invent 2025 Databases breakout sessions - YouTube playlist,总共有 37 场,有一些和 AI 相关,挑选一些了对自己有帮助的(大部分都感兴趣,利用早上和白天的空闲,都看了,看了还简单做了些笔记)。

AWS 数据库主要涉及:RDS(包括 Aurora RDS),Aurora DSQL(分布式数据库),DynamoDB,DocumentDB,ElastiCache(Valkey 是主要方向),和 Neptune 等,其他的,比如:Redshift、时序数据库也不能作为主要方向。

RDS 和 Aurora DSQL

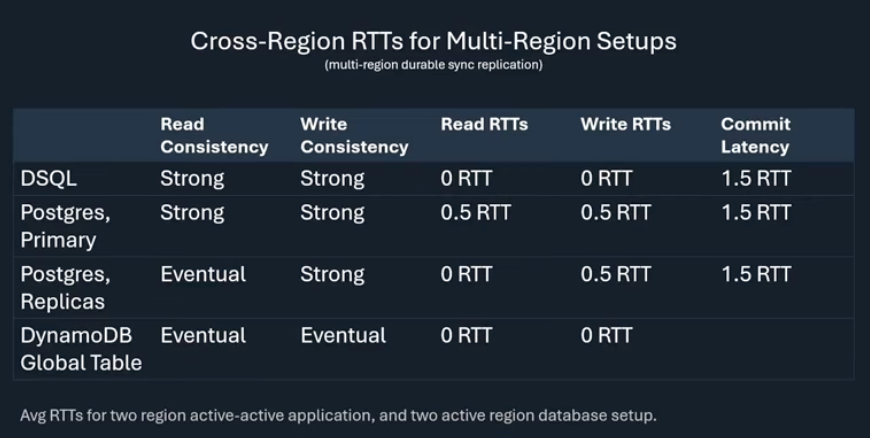
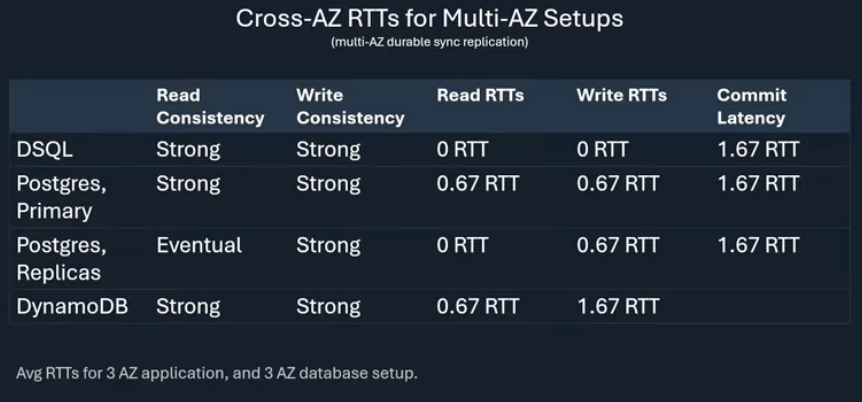
AWS re:Invent 2025 - A tale of two transactions (DAT455)

Marc Brooker 聊的一个话题,下面两张图是其主要想聊的内容,前面部分其实聊的有点无聊。

Multi AZ

Multi Region

AWS re:Invent 2025 - Amazon Aurora HA and DR design patterns for global resilience (DAT442)

AWS re:Invent 2025 - Deep dive into Amazon Aurora DSQL and its architecture (DAT439)

同一个人 Marc Bowes 参与了这两个 session;Aurora RDS 和 Aurora DSQL 是不同的设计,前者和 AWS RDS 也是不同的设计,主要体现在存储层;DSQL 是 NewSQL 分布式数据库非传统 SQL 数据库,可以实现强一致的多活读写。

Aurora RDS 应该是 AWS 持续投入的方向,DSQL 不一定有多少用户需要它(结合 2024 年阿里数据库研发同学写的文章看看 DSQL 的设计 https://baotiao.github.io/2024/12/15/aurora-2024-1.html)。

AWS re:Invent 2025 - Boost performance and reduce costs in Amazon Aurora and Amazon RDS (DAT312)

这个 session 不错,从计算、存储和备份以及 I/O 如何优化成本,通过选择合适的服务和类型,以及架构的调整。

AWS re:Invent 2025 - Revealing the northern lights: Amazon Aurora security deep dive (DAT456)

关于 Aurora 的安全机制。

AWS re:Invent 2025 - Deep dive into Amazon Aurora and its innovations (DAT441)

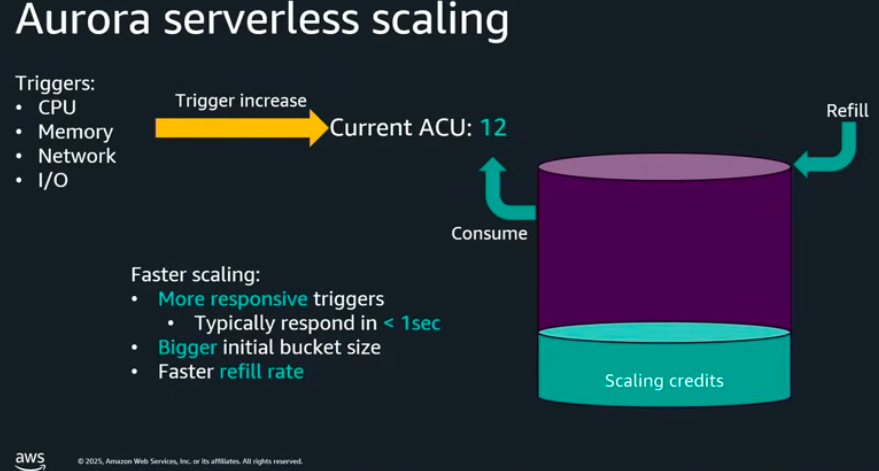
Aurora 的架构,也特别聊了 Aurora Serverless 的细节包括 scaling 的性能,如何升级打补丁,性能上优化,最后聊了 DSQL,非常好的一个 session。

Aurora serverless scaling

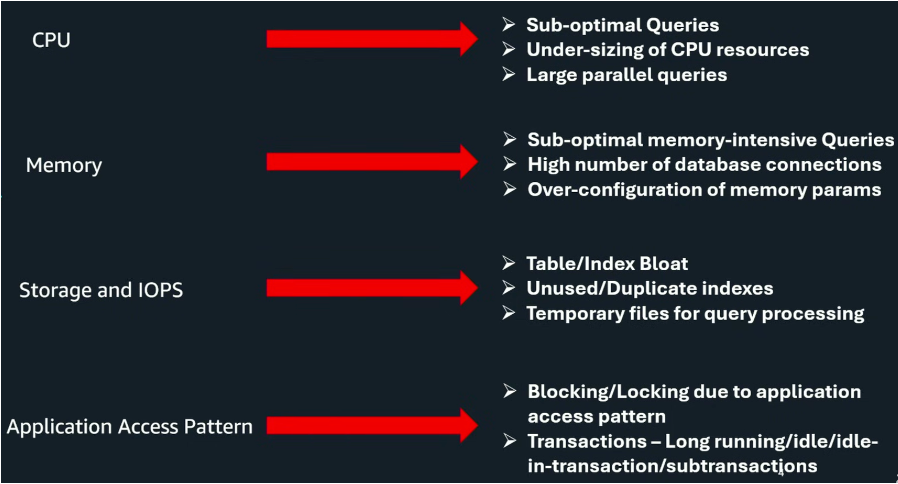
AWS re:Invent 2025 - PostgreSQL performance: Real-world workload tuning (DAT410)

有关于 PostgreSQL 性能调优。

PG perf

AWS re:Invent 2025 - Binge-worthy: Netflix's journey to Amazon Aurora at scale (DAT322)

如何第三方 PG 迁移到 Aurora PG,从迁移设计、工具开发、验证和切割展开,不错的参考(Netflix 也发了个博客文章 - Automating RDS Postgres to Aurora Postgres Migration | by Netflix Technology Blog | Feb, 2026 | Netflix TechBlog,文章里面有更详细的信息,也提到了上面 session 没提到的一些内容)。

AWS re:Invent 2025 - Amazon Aurora DSQL: A developer's perspective (DAT401)

开发者视角如何使用 DSQL,强一致,OCC 机制下需要处理事务冲突的异常。

DynamoDB

AWS re:Invent 2025 - DynamoDB: Resilience & lessons from the Oct 2025 service disruption (DAT453)
https://www.youtube.com/watch?v=YZUNNzLDWb8&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=8

2025 AWS 美东事故的剖析。

AWS re:Invent 2025 - How Samsung optimized 1.2 PB on Amazon DynamoDB with zero downtime (DAT323)

三星云的实际优化案例。

AWS re:Invent 2025 - Multi-Region strong consistency with Amazon DynamoDB global tables (DAT440)

MRSC vs. MREC 跨区域强一致性和最终一致性。

AWS re:Invent 2025 - Dive deep into Amazon DynamoDB (DAT435)

实际案例出发,讲的挺好,但是对我来说还是经验不够,理解不足,比如:第一个案例,hash 问题导致分区不工作。

AWS re:Invent 2025 - Advanced data modeling with Amazon DynamoDB (DAT414)

AWS re:Invent 2025 - Data modeling core concepts for Amazon DynamoDB (DAT311)

挺深入的,关于如何建模(不太懂 DynamoDB,为什么叫建模,而不是表的设计?),PK/SK (sort key)和 LSI/GSI(local second index,global second index) 等等等设计,以及可用性和增量备份,和 OpenSearch 等的集成,实际例子挺深入的,不错的 session。

DocumentDB

AWS re:Invent 2025 - Supercharge app intelligence using gen AI with Amazon DocumentDB (DAT313)

还是关于向量化存储和检索。

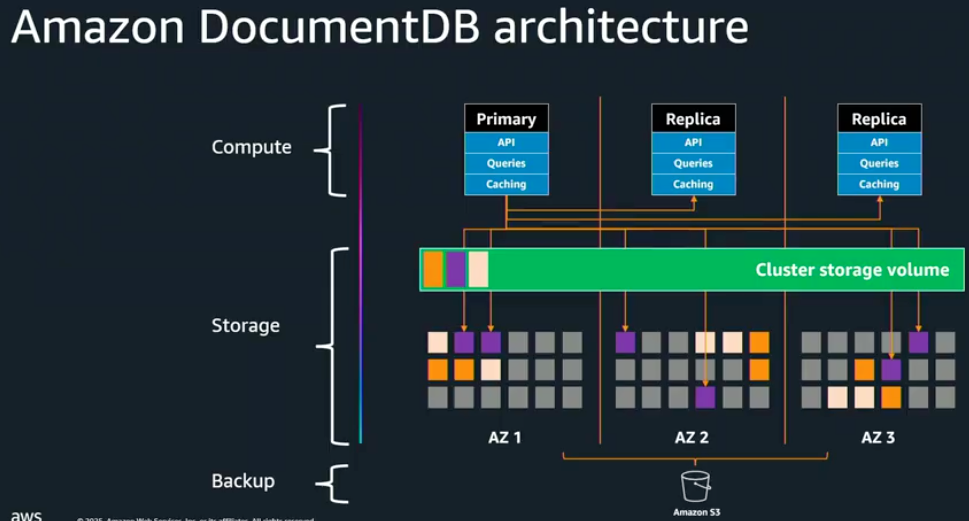
AWS re:Invent 2025 - Deep dive into Amazon DocumentDB and its innovations (DAT444)

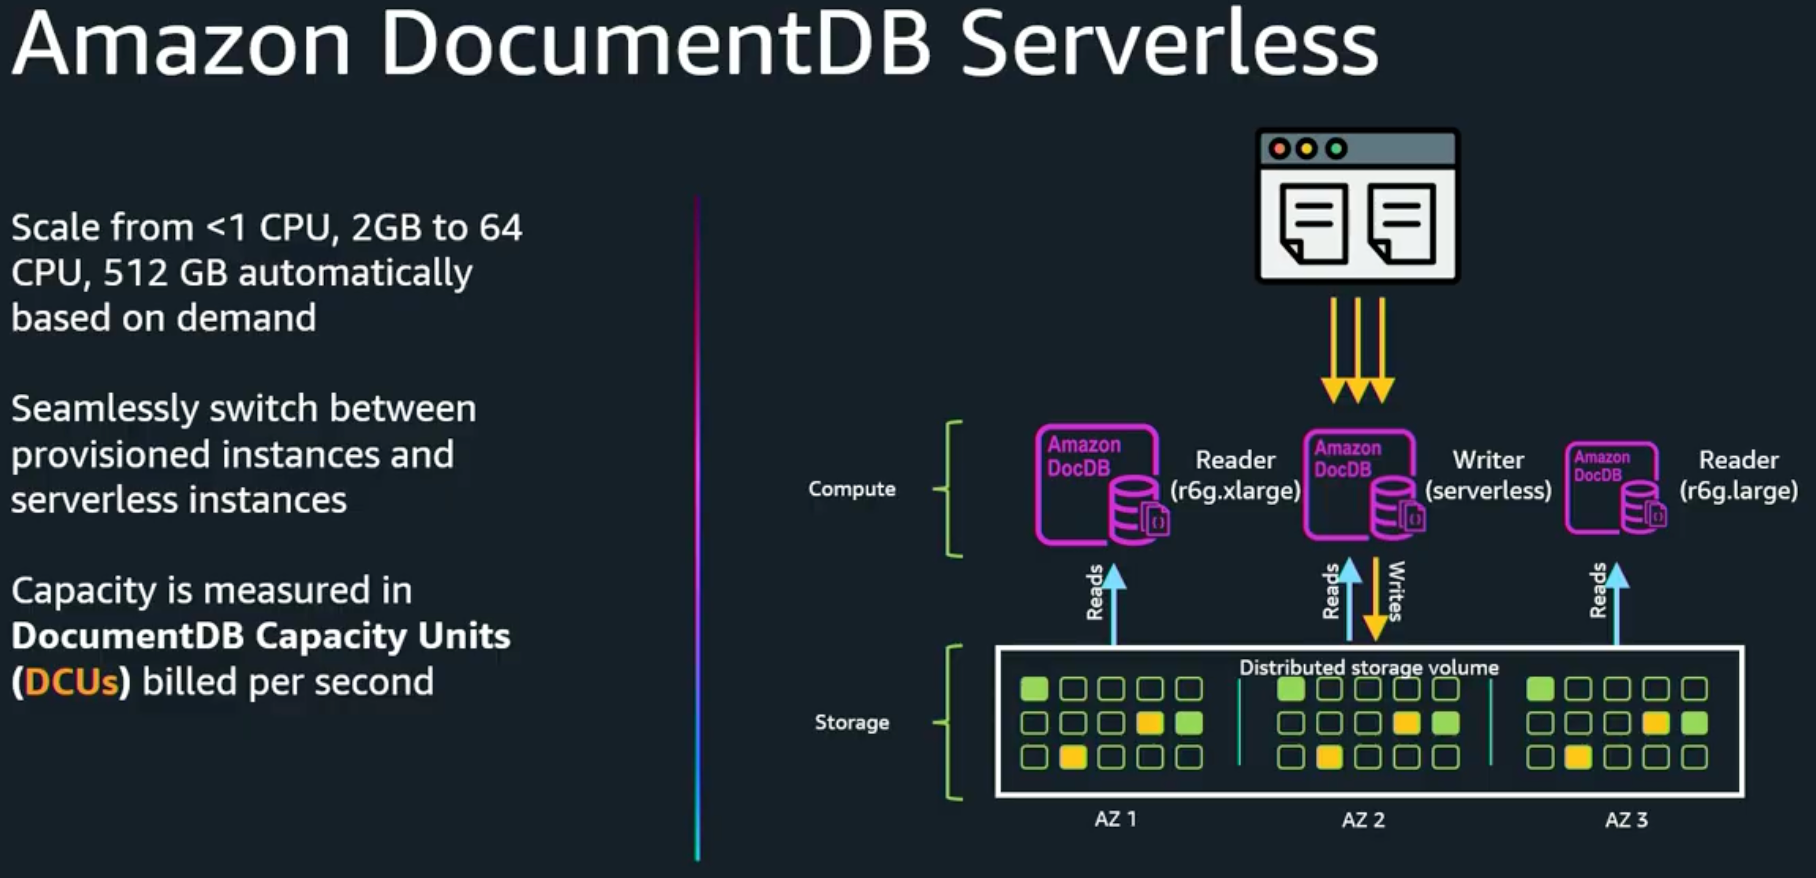
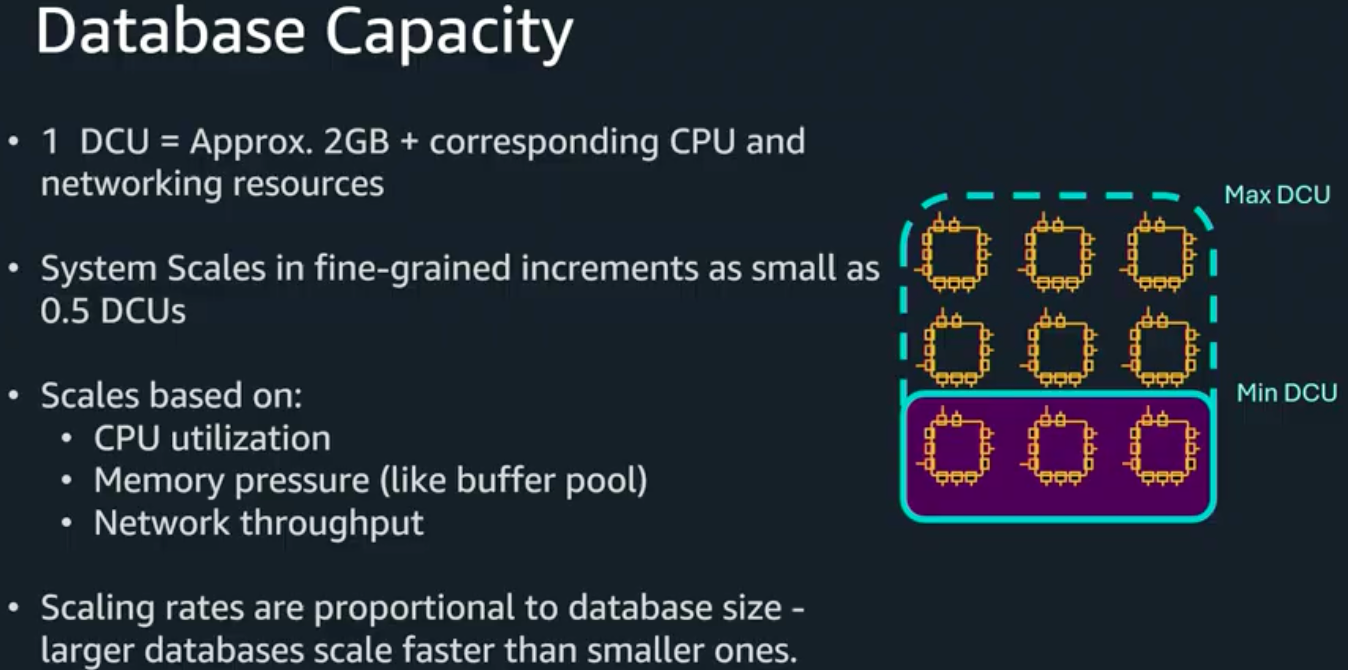
深入 DocumentDB 架构,特性,DocumentDB Servless 架构,深入了解 DocumentDB 的一个起点。

DocumentDB architecture

DocumentDB Serverless

DocumentDB Database Capability

ElastiCache Valkey

AWS re:Invent 2025 - Optimize agentic AI apps with semantic caching in Amazon ElastiCache (DAT451)

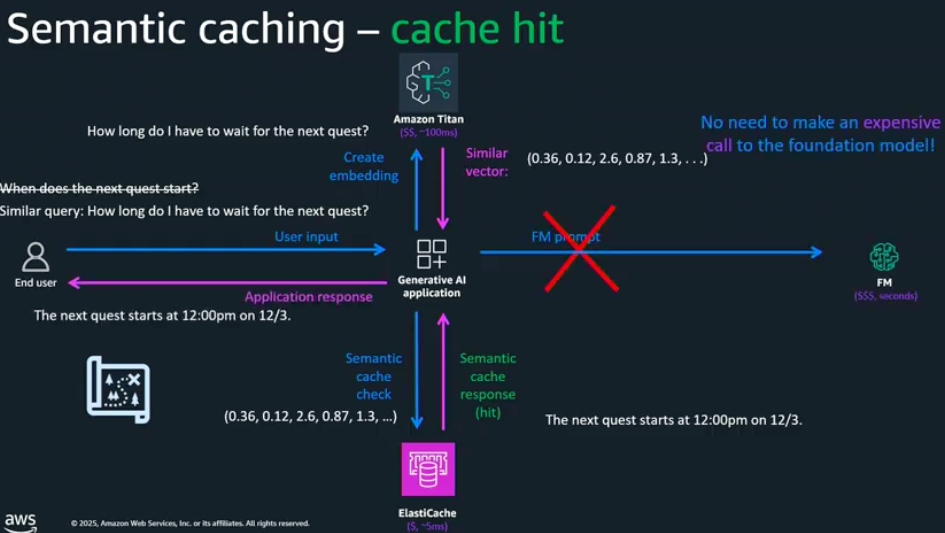
如何实现语义缓存和匹配,通过向量化存储和搜索。

[AWS re:Invent 2025 - Video sampling & search using ElastiCache & multimodal embeddings (DAT433)](https://www.youtube.com/watch?v=3Kbv_BI3NJ0&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=4]

对于视屏帧数据的多模态处理,Valkey 向量存储和检索。

AWS re:Invent 2025 - Advanced data modeling for Amazon ElastiCache (DAT438)

印象深刻的还是和 Valkey 如何存储向量和检索,semantic cacheing。

Cache hit

AWS re:Invent 2025 - Better, faster, cheaper: How Valkey is revolutionizing caching (DAT458)

撇开内容本身,看到的时候我在想作为 Director of Product Management 还能在台上游刃有余的讲产品和技术,并有足够的深度,这是我们需要学习的地方,一个技术公司需要这样。

Technical steering committee 有不少都是国人,也算厉害了;Valkey 是 Redis fork 出来的并开源了的。

聊了多线程架构

  • 给了一个火焰图分析,read/write command,特别是 write command 是栈最深的
  • main + IO thread 1, 2, ..., n: “While the core execution remains on a single thread to preserve data consistency, parsing commands and writing responses are offloaded to IO threads”
    存储和性能优化

最后是关于Roadmap - 未来会支持时序类型;不错的一个 session,有深入的内容。

[AWS re:Invent 2025 - Optimizing for high performance with Amazon ElastiCache Serverless (DAT437))(https://www.youtube.com/watch?v=fXB6wftmigU&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=34)

性能优化方面的。

Neptune

AWS re:Invent 2025 - Using graphs over your data lake to power generative AI applications (DAT447)

图数据库在 AI 时代越发重要了,如何结合数据湖,向量搜索、图 RAG 和记忆相关性。

其他 session

AWS re:Invent 2025 - Build serverless chatbots using Amazon ElastiCache & Aurora PostgreSQL (DAT314)

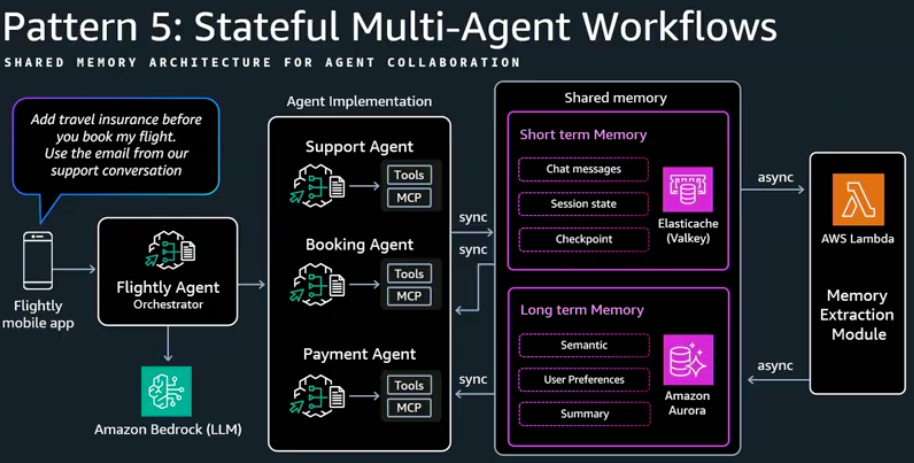
最后部分聊的 pattern,挺好的,短期和长期记忆分别存储于 Valkey 和 PG。

Pattern 5 - Multi Agent

小结

总的来说,AWS 在数据库方向除了分析型数湖仓和时序数据库方向之外,都有完整的布局和持续的投入,而且基本都提供 Serverless 选项,计费来说都是从软硬件结合为统一单位来看。

年前最后一天上班,办公室人不多,趁着有空把文摘整理一下发了(下图是测试一下在 cloudflare 上的图床。)

测试图床,来自 cloudflare

本周观影

  • 暂无

本周阅读

  • 《梦宫》:看完了,还行,big brother watching you
  • 在看《哲学家的最后一课》和《如何快速了解一个行业》
  • 春节期间还备着《九诗心》、《中国绘画:元至清(巫鸿“中国绘画”系列收官之作,重新理解中国绘画史)》和《万万没想到:用理工科思维理解世界》

本周博客

本周胡思乱想

  • 总是在和自己过不去,对于招聘上的失误,让公司和我自己承受了不应有的损失;对于团队管理来说招聘其实是第一要解决的问题,不然现在就是我现在的窘境,沟通和个性以及聪明度放在首位,其次就是考虑潜力,传统企业看人和互联网会有差异,不要有老眼光去看人和用人,一个方面说跑好当前业务就行。
  • 我最近越发感觉现在 tob 服务的公司,在利润压力下,对于人是越来越没培养和优选了,好多时候就是“糊弄和骗”客户的钱,怀念当初 IBM 不断出大钱给大家做培训的时光,当初不觉珍惜,现在回看是多么的宝贵。
  • AI 没创造啥,人类自己给自己降智了。
  • 现在看着长文就没多大耐心,这个是有问题,如果都这样未来就没人产出真正的内容,因为没人看,除了自己(训练自己最重要,但是好的文章没人看也是可惜),我还是要给自己耐心结合 AI 的学习方法,但不要失去耐心和纯粹依赖 AI。
  • 数据一方面是新的需求 比如 向量化/语义化存储 短期和长期结合 需要 cache 和数据库结合 图数据库又变得非常重要 识别相关性 一方面厂商产品都在引入原生的 ai 能力,开发 分析和运维,过去的架构和开发手段是否合适也要看一下了 毕竟如果走到 ai native 时代 开发方式本身就不一样了;数据我设想是所有数据都堆到多模态数据湖上,通过自然语言和 AI Agent 进行数据分析探查。

本周文章

玉伯在推上的创业感言

赚钱不丢人,但要行得正,站着赚钱。


1、一切皆可造假。什么 ARR、月访问量、营收数据、DAU、PMF 等,一切都可以通过钱解决。我选择了不。什么竞品分析,都是浪费时间。哪怕尊敬的 Manus,说什么营销广告费用为零,都是骗小孩的玩意。

2、最重要的是愿景。愿景只有两种:赚大钱,或做成某件事。我之前很笃定做成某件事更重要。创业近两年,我的观念产生了很大转变,最重要的还是赚钱,只是要坚持站着把钱赚了,那么背后的事,就一定是件很尊敬的事。赚钱才是头等大事,要坚持的不是事,而是站着。

3、好玩   〉好看  〉好用。AI 时代,在好玩面前,一切好用都失效。我说的是 To C 市场,To B 市场的创业,我不懂。一个 To C 的 AI 产品,如果不好玩,就没做的必要。同时要切记,不要被 VC 带歪。VC 机构都是后知后觉的。哪怕 a16z,都落后得不行。

祛魅吧,让一切归零。
建魅吧,让一切激情澎湃。

The Final Bottleneck


“一次性塑料软件”的兴起,人类的责任也许在他出,而不是原有 pipeline 的一个个 coder,一个个 reviewer;挺好的反思,人类到底何去何从,在 AI 时代,也没啥答案,但历史滚滚向前。

AI 时代,感觉越往底层做越有搞头,基础设施的管理和大模型的训练等等,开发个 agent 啥的除了通用大的,其他的可以是个“一次性的塑料软件”,即用即抛型。

As we’re entering the phase of single-use plastic software, we might be moving the whole layer of responsibility elsewhere.


提完离职后,我想聊聊我的择业观


写的我都认同,,但是人到了一定年纪结合市场情况,能有持续能力和动力换工作的,可能真不是一般人了,我也希望自己可以,但是现实又是就是很残酷,道理都懂就是过不好这一生,无论如何我不会在“退休”前放弃“挣扎”和努力。

最简单的一个判断标准是:如果你现在出去找工作,你目前手里做的事情,有哪些是可以拿出来说的加分点?如果你思前想后给不出答案,那么要么你需要把这些当作接下来的攻克目标,要么你可能真的需要换个地方了。

这因人而异。如果你追求安稳,守好自己的一亩三分地也挺好。但如果你希望在职业生涯中保持成长,我认为 3 年是一个关键节点。

如果你对现状不满,想换个环境,别总是在深夜感叹,要做的是真正行动起来。止步不前只会让现状每况愈下。共勉。

Vector search using only Parquet and DataFusion

通过改造 Parquest 和 DataFussion 实现对于向量存储和查询的支持。

和工作无关,更多是自己个人学习、思考和输出的需要,做自己个人喜欢的事情,做对的事情。

晨间例程 Morning routine
• 看股市和雪球,写点心的
• 看 X、Telegram、公众号(公众号我只看很少数的几个),记录所见和自己的思考
• 通过 Feedly RSS 读博客,记录所见和自己的思考(用 Gemini 总结),发现有些需要一段时间好好读的文章,会先记录下来找时间慢慢读完(对自己要求是不要 FOMO,也不求快,求精)
• AI Coding with Github Copilot,这个不一定每天,我的问题是不知道构建啥,正在做的也是做着做着就半途而废了
• 读书,这个是穿插在整天的

中午例程 Noon routine
• 更多是休息,可以用逛逛 X 和Telegram,还有就是 RSS 订阅的 investment 部分,中午时间不烧脑可以快速过一下,记录点每日速览的信息

夜间例程 Night routine - 实际看晚上其实我做的少,到家吃完饭,休息完运动会,洗完澡也基本上就没更多精力了
• 逛逛 X 和 Telegram
• 读点书
• 有时间可能玩会游戏

上面其实日常工作日的例程,周末的话,总结一周的内容完成每周的文摘,自己的思考和输出更重要,同时如果有其他文章也一并写了;其次,就是看片,纪录片和好的电影;最后,就是游戏,主要就是魔兽世界。