分类 默认分类 下的文章

过年的一周,走亲戚看长辈,一年又一年,过年至于我只是一个象征意义,没有特别的感觉了,不像小时候那时候期盼可以放鞭炮,一个一个扔的那种。

本周观影

  • 没看片,《同乐者》第一季开了个头

本周阅读

  • 《如何快速了解一行业》:不错的一本书,麦肯锡前分析师写的,比较体系化,和投资有一定的关联的关系,教的还是一套方法和框架,典型的咨询方法论
  • 《九诗心》:发现不太看不下去(没啥特别的体系,特别发散,而且容易说“大词”太“浮夸”的感觉),准备先放一放

本周播客

  • 《过年六必黑》:每年初一到初六听六哥和黑叔叔(陈晓卿)唠嗑,挺有意思的

本周胡思乱想

  • 学习、思考和游戏的另一天,现在突然回顾一下,之前假期一直是处理和学习工作相关的内容多,现在反而是走在了一条新路子上,学习的是投资和 AI 相关的信息,看的书好多也是和投资相关的,工作相关性在减弱,究其原因是因为目前工作上其实本身已经很熟悉了,而且也没啥有特别多的工作内容和挑战,还有就是本身方向上来说其实我也觉得意义不大,好还是不好?从我内心来讲是希望有更多的事情和方向,但是现实往往不如我意,只能勉强做着,但是还是不要放弃对于目前外部世界和机会的追寻,特别是继续保持我的好奇心,我要做的更多是如何持续构建,而不只是学习和想。

本周文章

2025,全新旅途

真厉害,无聊履历还是自己的思考,文中提到的 PKM(个人知识管理)有参考意义,但是我一直犹豫是否用第三方工具,如:Tana,不过目前因为公司 Mac 限制,我用了 Day One,过去一段时间也一直在尝试考虑 AI Native 的学习和写作方式,作者写的也是很好的参考。

之前有提到过我使用的笔记软件是 Tana +Heptabase,但在 AI 时代下,我基本上只使用 Tana了。
* 使用自定义的 AI Command 进行扩展探索
* Bookmark 自动总结生图
* 无限递归的深入探索
* 结合 OpenClaw 调用和保存
NotenookLM
用了一年多,主要用来深度检索,比如遇到某个问题直接让 NotebookLM 自己补齐材料,然后点击生成 PPT,让自己通过这个 PPT 快速了解这个领域的 Outline,根据知识点快速建立其一个初步的框架。‘
一旦建立了框架,深入学习时的提问就有了方向。后续如果要回到 Tana 进行无限递归的深入探索,学会高效地去提问是很重要的,这样 #question supertag 反哺给自己的信息密度才够高。

老马有一个页面关于 TW 和他组织的关于软件研发未来的工作坊,同时也是敏捷软件宣言 25 周年的纪念日: https://martinfowler.com/bliki/FutureOfSoftwareDevelopment.html

同时写了几个碎片,关于不同的话题,对于 18 号那个需要仔细看看,同时也有其他人的小结:

还有也发布了一个 future of_software_development_retreat key_takeaways pdf(https://www.thoughtworks.com/content/dam/thoughtworks/documents/report/tw_future%20_of_software_development_retreat_%20key_takeaways.pdf),从八个方面做了总结。

"We kept asking the same question in every room: if AI handles the code,
where does the engineering actually go? Nobody had the same answer. But
everybody agreed the question is urgent."

“我们在每个房间里都在问同一个问题:如果 AI 负责代码,工程到底去哪儿了?没有人给出同样的答案。但大家都同意这个问题很紧急。”
  1. Where does the rigor go? 严谨性去哪里了?
  2. The middle loop: a new category of work
  3. Agent topologies and enterprise architecture
  4. Self-healing and self-improving systems
  5. The human side: roles, skills and experience
  6. Technical foundations: languages, semantics and operating systems
  7. Security, governance and the future of agile
  8. Agent swarms: beyond sequential thinking

https://annievella.com/posts/finding-comfort-in-the-uncertainty/ 摘录文中一段,如下:


I walked into that room expecting to learn from people who were further ahead. People who’d cracked the code on how to adopt AI at scale, how to restructure teams around it, how to make it work. Some of the sharpest minds in the software industry were sitting around those tables.

And nobody has it all figured out.

There is more uncertainty than certainty. About how to use AI well, what it’s really doing to productivity, how roles are shifting, what the impact will be, how things will evolve. Everyone is working it out as they go.

I actually found that to be quite comforting, in many ways. Yes, we walked away with more questions than answers, but at least we now have a shared understanding of the sorts of questions we should be asking. That might be the most valuable outcome of all.

我走进那个房间,期待向那些更领先的人学习。那些已经破解了如何大规模采用人工智能、如何围绕它重组团队、如何让它发挥作用的人。一些软件行业中最敏锐的头脑就坐在那些桌子周围。

没有人能完全搞清楚。

不确定性大于确定性。关于如何好好使用人工智能,它对生产力真正的影响,角色如何转变,其影响是什么,事情将如何发展。每个人都在边做边摸索。

实际上,在很多方面,我发现这让我感到相当安心。是的,我们带着比答案更多的问题离开了,但至少我们现在对应该问哪些问题有了共同的理解。这可能是所有中最有价值的成果。

上面这些都是对于 AI/LLM 驱动软件研发未来非常理性的思考和讨论,集合了好多业内人士的智慧,值得学习和反思,等我看完消化完,我要写篇文章梳理一下。
持续更新中

AWS re:Invent 2025 Databases breakout sessions - YouTube playlist,总共有 37 场,有一些和 AI 相关,挑选一些了对自己有帮助的(大部分都感兴趣,利用早上和白天的空闲,都看了,看了还简单做了些笔记)。

AWS 数据库主要涉及:RDS(包括 Aurora RDS),Aurora DSQL(分布式数据库),DynamoDB,DocumentDB,ElastiCache(Valkey 是主要方向),和 Neptune 等,其他的,比如:Redshift、时序数据库也不能作为主要方向。

RDS 和 Aurora DSQL

AWS re:Invent 2025 - A tale of two transactions (DAT455)

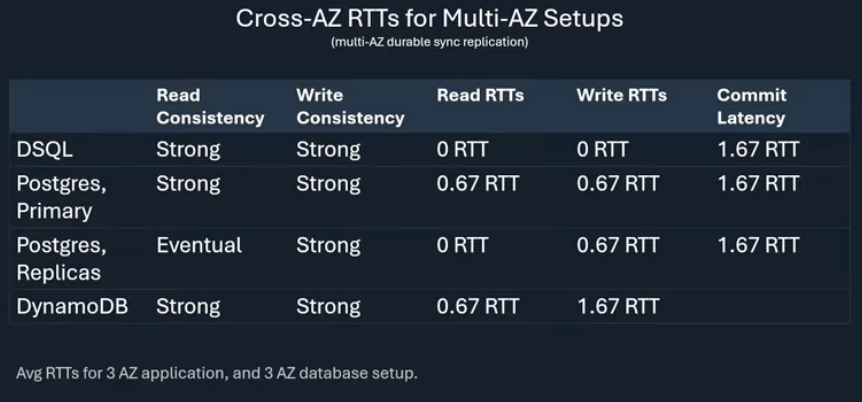
Marc Brooker 聊的一个话题,下面两张图是其主要想聊的内容,前面部分其实聊的有点无聊。

Multi AZ

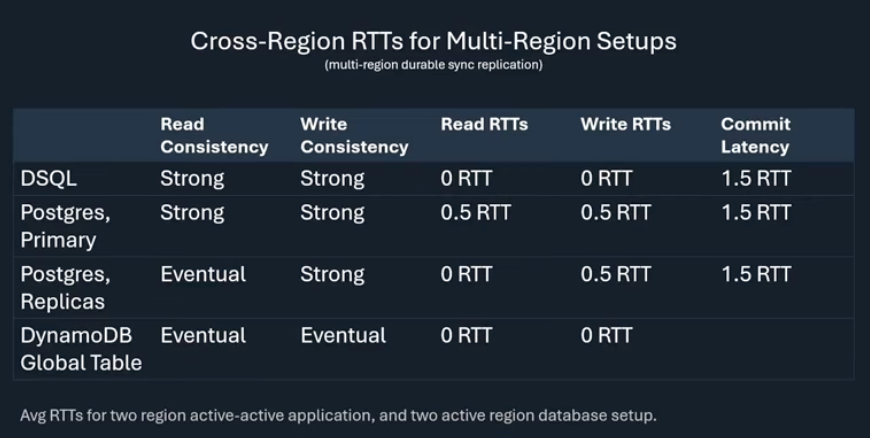
Multi Region

AWS re:Invent 2025 - Amazon Aurora HA and DR design patterns for global resilience (DAT442)

AWS re:Invent 2025 - Deep dive into Amazon Aurora DSQL and its architecture (DAT439)

同一个人 Marc Bowes 参与了这两个 session;Aurora RDS 和 Aurora DSQL 是不同的设计,前者和 AWS RDS 也是不同的设计,主要体现在存储层;DSQL 是 NewSQL 分布式数据库非传统 SQL 数据库,可以实现强一致的多活读写。

Aurora RDS 应该是 AWS 持续投入的方向,DSQL 不一定有多少用户需要它(结合 2024 年阿里数据库研发同学写的文章看看 DSQL 的设计 https://baotiao.github.io/2024/12/15/aurora-2024-1.html)。

AWS re:Invent 2025 - Boost performance and reduce costs in Amazon Aurora and Amazon RDS (DAT312)

这个 session 不错,从计算、存储和备份以及 I/O 如何优化成本,通过选择合适的服务和类型,以及架构的调整。

AWS re:Invent 2025 - Revealing the northern lights: Amazon Aurora security deep dive (DAT456)

关于 Aurora 的安全机制。

AWS re:Invent 2025 - Deep dive into Amazon Aurora and its innovations (DAT441)

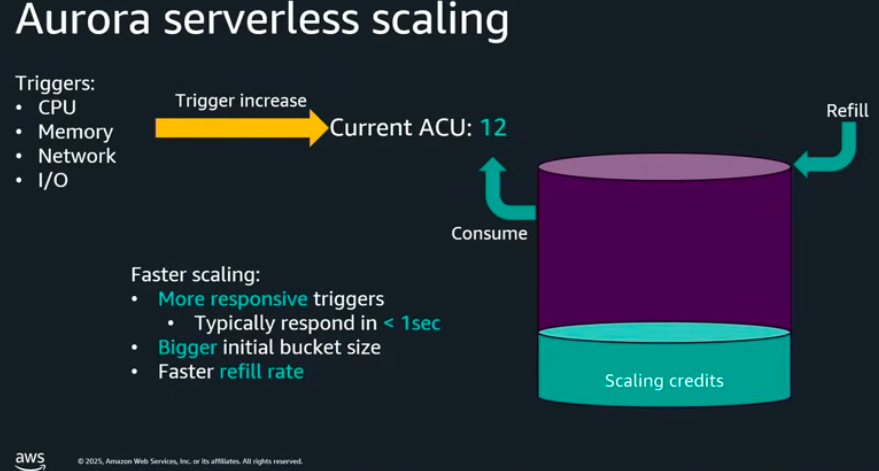
Aurora 的架构,也特别聊了 Aurora Serverless 的细节包括 scaling 的性能,如何升级打补丁,性能上优化,最后聊了 DSQL,非常好的一个 session。

Aurora serverless scaling

AWS re:Invent 2025 - PostgreSQL performance: Real-world workload tuning (DAT410)

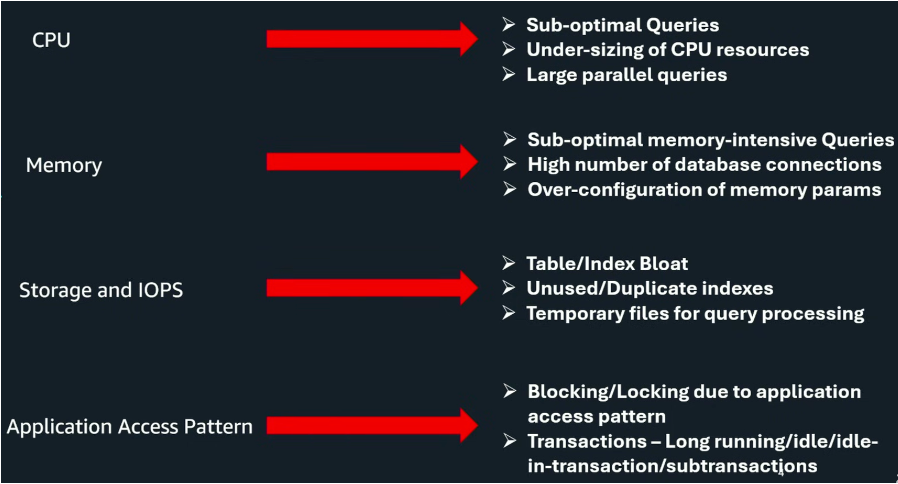
有关于 PostgreSQL 性能调优。

PG perf

AWS re:Invent 2025 - Binge-worthy: Netflix's journey to Amazon Aurora at scale (DAT322)

如何第三方 PG 迁移到 Aurora PG,从迁移设计、工具开发、验证和切割展开,不错的参考(Netflix 也发了个博客文章 - Automating RDS Postgres to Aurora Postgres Migration | by Netflix Technology Blog | Feb, 2026 | Netflix TechBlog,文章里面有更详细的信息,也提到了上面 session 没提到的一些内容)。

AWS re:Invent 2025 - Amazon Aurora DSQL: A developer's perspective (DAT401)

开发者视角如何使用 DSQL,强一致,OCC 机制下需要处理事务冲突的异常。

DynamoDB

AWS re:Invent 2025 - DynamoDB: Resilience & lessons from the Oct 2025 service disruption (DAT453)
https://www.youtube.com/watch?v=YZUNNzLDWb8&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=8

2025 AWS 美东事故的剖析。

AWS re:Invent 2025 - How Samsung optimized 1.2 PB on Amazon DynamoDB with zero downtime (DAT323)

三星云的实际优化案例。

AWS re:Invent 2025 - Multi-Region strong consistency with Amazon DynamoDB global tables (DAT440)

MRSC vs. MREC 跨区域强一致性和最终一致性。

AWS re:Invent 2025 - Dive deep into Amazon DynamoDB (DAT435)

实际案例出发,讲的挺好,但是对我来说还是经验不够,理解不足,比如:第一个案例,hash 问题导致分区不工作。

AWS re:Invent 2025 - Advanced data modeling with Amazon DynamoDB (DAT414)

AWS re:Invent 2025 - Data modeling core concepts for Amazon DynamoDB (DAT311)

挺深入的,关于如何建模(不太懂 DynamoDB,为什么叫建模,而不是表的设计?),PK/SK (sort key)和 LSI/GSI(local second index,global second index) 等等等设计,以及可用性和增量备份,和 OpenSearch 等的集成,实际例子挺深入的,不错的 session。

DocumentDB

AWS re:Invent 2025 - Supercharge app intelligence using gen AI with Amazon DocumentDB (DAT313)

还是关于向量化存储和检索。

AWS re:Invent 2025 - Deep dive into Amazon DocumentDB and its innovations (DAT444)

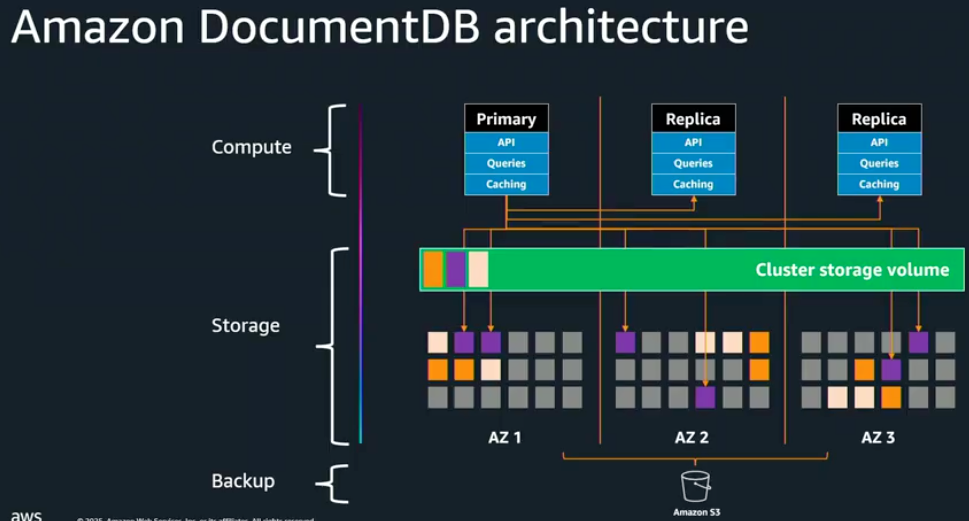
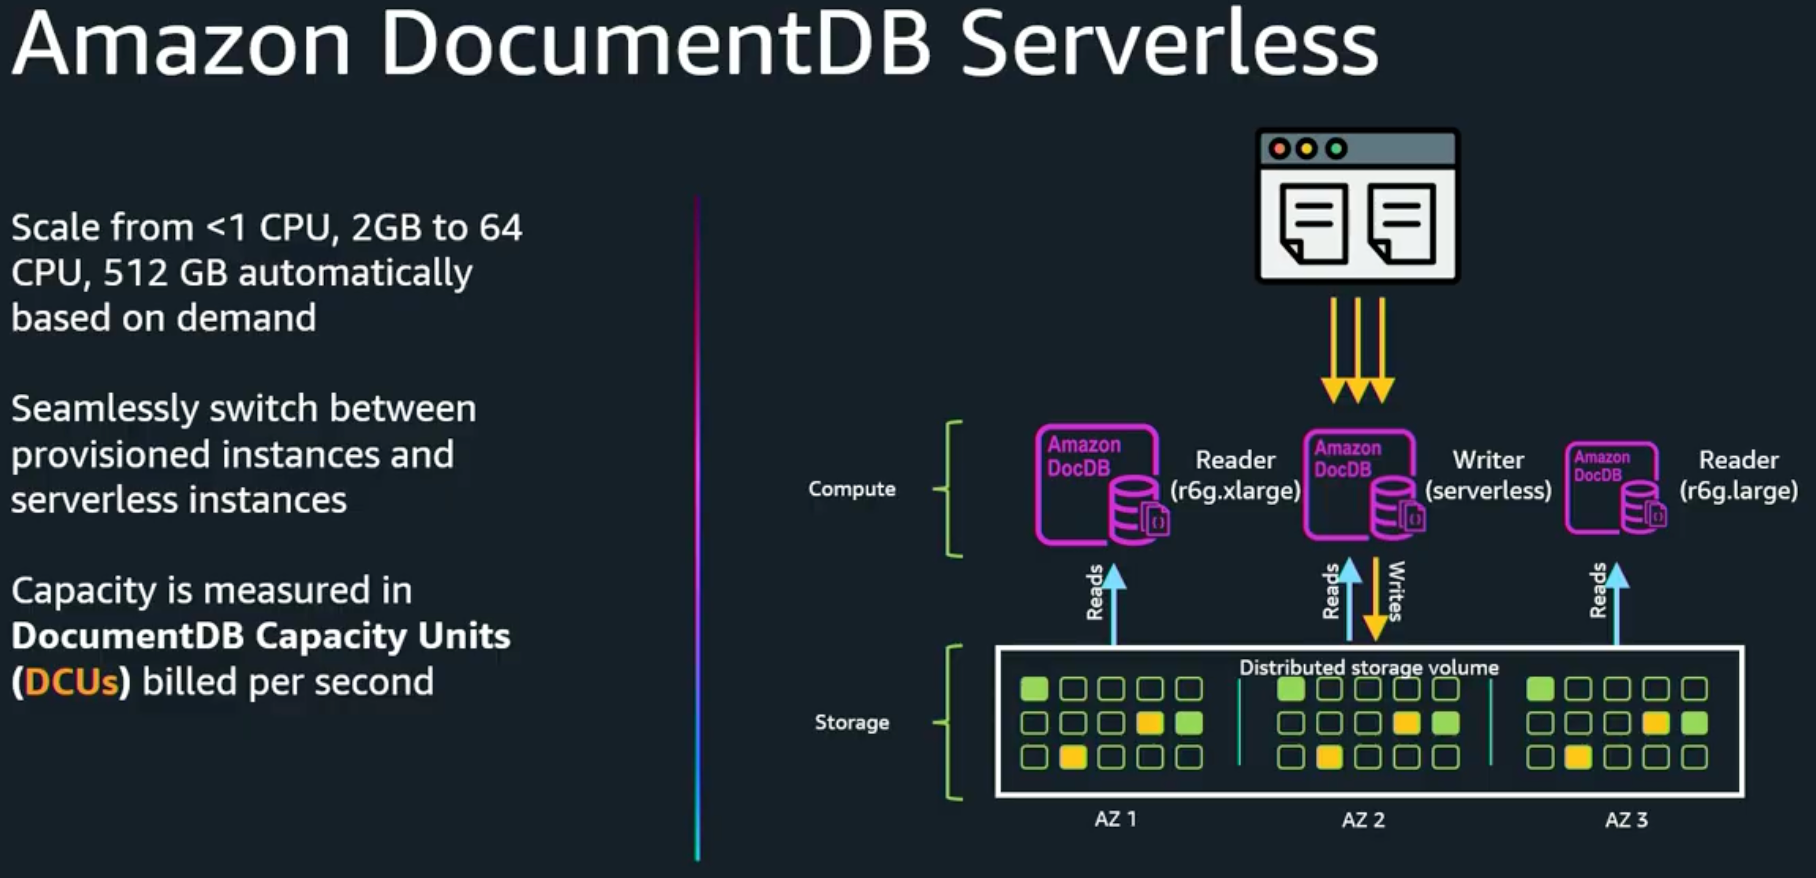
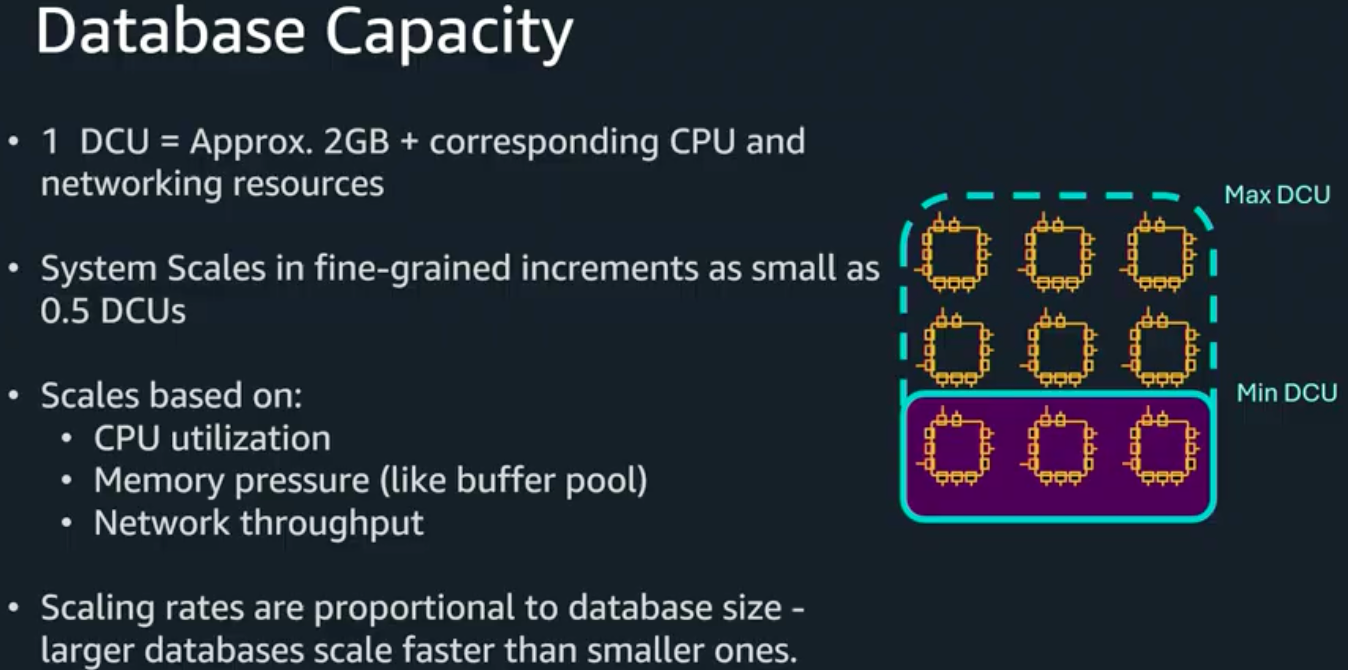
深入 DocumentDB 架构,特性,DocumentDB Servless 架构,深入了解 DocumentDB 的一个起点。

DocumentDB architecture

DocumentDB Serverless

DocumentDB Database Capability

ElastiCache Valkey

AWS re:Invent 2025 - Optimize agentic AI apps with semantic caching in Amazon ElastiCache (DAT451)

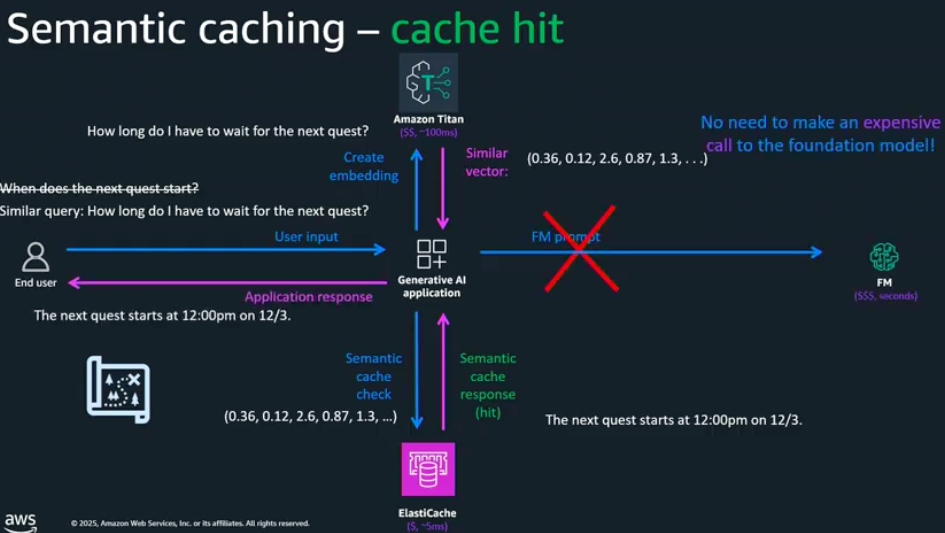
如何实现语义缓存和匹配,通过向量化存储和搜索。

[AWS re:Invent 2025 - Video sampling & search using ElastiCache & multimodal embeddings (DAT433)](https://www.youtube.com/watch?v=3Kbv_BI3NJ0&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=4]

对于视屏帧数据的多模态处理,Valkey 向量存储和检索。

AWS re:Invent 2025 - Advanced data modeling for Amazon ElastiCache (DAT438)

印象深刻的还是和 Valkey 如何存储向量和检索,semantic cacheing。

Cache hit

AWS re:Invent 2025 - Better, faster, cheaper: How Valkey is revolutionizing caching (DAT458)

撇开内容本身,看到的时候我在想作为 Director of Product Management 还能在台上游刃有余的讲产品和技术,并有足够的深度,这是我们需要学习的地方,一个技术公司需要这样。

Technical steering committee 有不少都是国人,也算厉害了;Valkey 是 Redis fork 出来的并开源了的。

聊了多线程架构

  • 给了一个火焰图分析,read/write command,特别是 write command 是栈最深的
  • main + IO thread 1, 2, ..., n: “While the core execution remains on a single thread to preserve data consistency, parsing commands and writing responses are offloaded to IO threads”
    存储和性能优化

最后是关于Roadmap - 未来会支持时序类型;不错的一个 session,有深入的内容。

[AWS re:Invent 2025 - Optimizing for high performance with Amazon ElastiCache Serverless (DAT437))(https://www.youtube.com/watch?v=fXB6wftmigU&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=34)

性能优化方面的。

Neptune

AWS re:Invent 2025 - Using graphs over your data lake to power generative AI applications (DAT447)

图数据库在 AI 时代越发重要了,如何结合数据湖,向量搜索、图 RAG 和记忆相关性。

其他 session

AWS re:Invent 2025 - Build serverless chatbots using Amazon ElastiCache & Aurora PostgreSQL (DAT314)

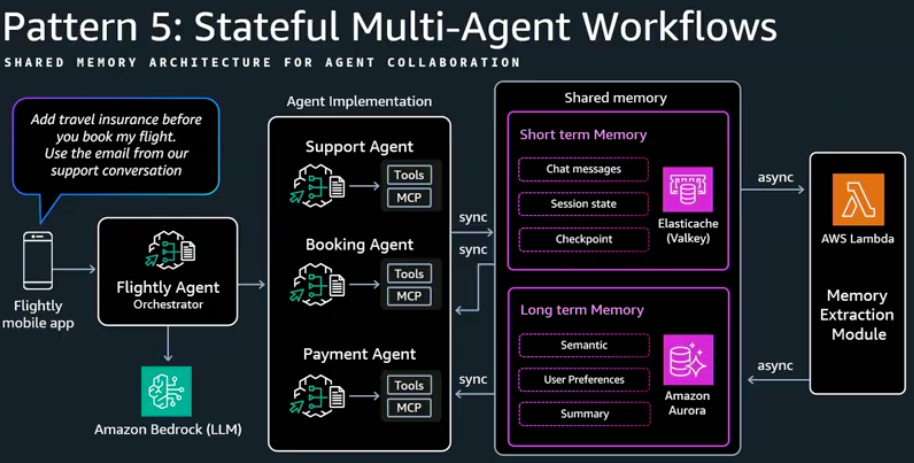
最后部分聊的 pattern,挺好的,短期和长期记忆分别存储于 Valkey 和 PG。

Pattern 5 - Multi Agent

小结

总的来说,AWS 在数据库方向除了分析型数湖仓和时序数据库方向之外,都有完整的布局和持续的投入,而且基本都提供 Serverless 选项,计费来说都是从软硬件结合为统一单位来看。

年前最后一天上班,办公室人不多,趁着有空把文摘整理一下发了(下图是测试一下在 cloudflare 上的图床。)

测试图床,来自 cloudflare

本周观影

  • 暂无

本周阅读

  • 《梦宫》:看完了,还行,big brother watching you
  • 在看《哲学家的最后一课》和《如何快速了解一个行业》
  • 春节期间还备着《九诗心》、《中国绘画:元至清(巫鸿“中国绘画”系列收官之作,重新理解中国绘画史)》和《万万没想到:用理工科思维理解世界》

本周博客

本周胡思乱想

  • 总是在和自己过不去,对于招聘上的失误,让公司和我自己承受了不应有的损失;对于团队管理来说招聘其实是第一要解决的问题,不然现在就是我现在的窘境,沟通和个性以及聪明度放在首位,其次就是考虑潜力,传统企业看人和互联网会有差异,不要有老眼光去看人和用人,一个方面说跑好当前业务就行。
  • 我最近越发感觉现在 tob 服务的公司,在利润压力下,对于人是越来越没培养和优选了,好多时候就是“糊弄和骗”客户的钱,怀念当初 IBM 不断出大钱给大家做培训的时光,当初不觉珍惜,现在回看是多么的宝贵。
  • AI 没创造啥,人类自己给自己降智了。
  • 现在看着长文就没多大耐心,这个是有问题,如果都这样未来就没人产出真正的内容,因为没人看,除了自己(训练自己最重要,但是好的文章没人看也是可惜),我还是要给自己耐心结合 AI 的学习方法,但不要失去耐心和纯粹依赖 AI。
  • 数据一方面是新的需求 比如 向量化/语义化存储 短期和长期结合 需要 cache 和数据库结合 图数据库又变得非常重要 识别相关性 一方面厂商产品都在引入原生的 ai 能力,开发 分析和运维,过去的架构和开发手段是否合适也要看一下了 毕竟如果走到 ai native 时代 开发方式本身就不一样了;数据我设想是所有数据都堆到多模态数据湖上,通过自然语言和 AI Agent 进行数据分析探查。

本周文章

玉伯在推上的创业感言

赚钱不丢人,但要行得正,站着赚钱。


1、一切皆可造假。什么 ARR、月访问量、营收数据、DAU、PMF 等,一切都可以通过钱解决。我选择了不。什么竞品分析,都是浪费时间。哪怕尊敬的 Manus,说什么营销广告费用为零,都是骗小孩的玩意。

2、最重要的是愿景。愿景只有两种:赚大钱,或做成某件事。我之前很笃定做成某件事更重要。创业近两年,我的观念产生了很大转变,最重要的还是赚钱,只是要坚持站着把钱赚了,那么背后的事,就一定是件很尊敬的事。赚钱才是头等大事,要坚持的不是事,而是站着。

3、好玩   〉好看  〉好用。AI 时代,在好玩面前,一切好用都失效。我说的是 To C 市场,To B 市场的创业,我不懂。一个 To C 的 AI 产品,如果不好玩,就没做的必要。同时要切记,不要被 VC 带歪。VC 机构都是后知后觉的。哪怕 a16z,都落后得不行。

祛魅吧,让一切归零。
建魅吧,让一切激情澎湃。

The Final Bottleneck

“一次性塑料软件”的兴起,人类的责任也许在他出,而不是原有 pipeline 的一个个 coder,一个个 reviewer;挺好的反思,人类到底何去何从,在 AI 时代,也没啥答案,但历史滚滚向前。

AI 时代,感觉越往底层做越有搞头,基础设施的管理和大模型的训练等等,开发个 agent 啥的除了通用大的,其他的可以是个“一次性的塑料软件”,即用即抛型。

As we’re entering the phase of single-use plastic software, we might be moving the whole layer of responsibility elsewhere.


提完离职后,我想聊聊我的择业观

写的我都认同,,但是人到了一定年纪结合市场情况,能有持续能力和动力换工作的,可能真不是一般人了,我也希望自己可以,但是现实又是就是很残酷,道理都懂就是过不好这一生,无论如何我不会在“退休”前放弃“挣扎”和努力。

最简单的一个判断标准是:如果你现在出去找工作,你目前手里做的事情,有哪些是可以拿出来说的加分点?如果你思前想后给不出答案,那么要么你需要把这些当作接下来的攻克目标,要么你可能真的需要换个地方了。

这因人而异。如果你追求安稳,守好自己的一亩三分地也挺好。但如果你希望在职业生涯中保持成长,我认为 3 年是一个关键节点。

如果你对现状不满,想换个环境,别总是在深夜感叹,要做的是真正行动起来。止步不前只会让现状每况愈下。共勉。

Vector search using only Parquet and DataFusion

通过改造 Parquest 和 DataFussion 实现对于向量存储和查询的支持。

和工作无关,更多是自己个人学习、思考和输出的需要,做自己个人喜欢的事情,做对的事情。

晨间例程 Morning routine
• 看股市和雪球,写点心的
• 看 X、Telegram、公众号(公众号我只看很少数的几个),记录所见和自己的思考
• 通过 Feedly RSS 读博客,记录所见和自己的思考(用 Gemini 总结),发现有些需要一段时间好好读的文章,会先记录下来找时间慢慢读完(对自己要求是不要 FOMO,也不求快,求精)
• AI Coding with Github Copilot,这个不一定每天,我的问题是不知道构建啥,正在做的也是做着做着就半途而废了
• 读书,这个是穿插在整天的

中午例程 Noon routine
• 更多是休息,可以用逛逛 X 和Telegram,还有就是 RSS 订阅的 investment 部分,中午时间不烧脑可以快速过一下,记录点每日速览的信息

夜间例程 Night routine - 实际看晚上其实我做的少,到家吃完饭,休息完运动会,洗完澡也基本上就没更多精力了
• 逛逛 X 和 Telegram
• 读点书
• 有时间可能玩会游戏

上面其实日常工作日的例程,周末的话,总结一周的内容完成每周的文摘,自己的思考和输出更重要,同时如果有其他文章也一并写了;其次,就是看片,纪录片和好的电影;最后,就是游戏,主要就是魔兽世界。

个人感兴趣的一些方向,每个方向的链接从:https://www.youtube.com/@AWSEventsChannel 页面的 AWS re:Invent 2025 Breakout Sessions Tracks 找。

其他信息

Find a curated list of serverless videos on Serverless Land YouTube(https://aws.amazon.com/blogs/compute/serverless-icymi-q4-2025/ 提到的),Serverless 相关的 sessions
https://www.youtube.com/playlist?list=PLJo-rJlep0ECbKWbv1Ie-MdKFfSmqjmma