周末在老家,看看油菜花,一年又一年,美好的季节又到了(记得上张油菜花的图 - done)。
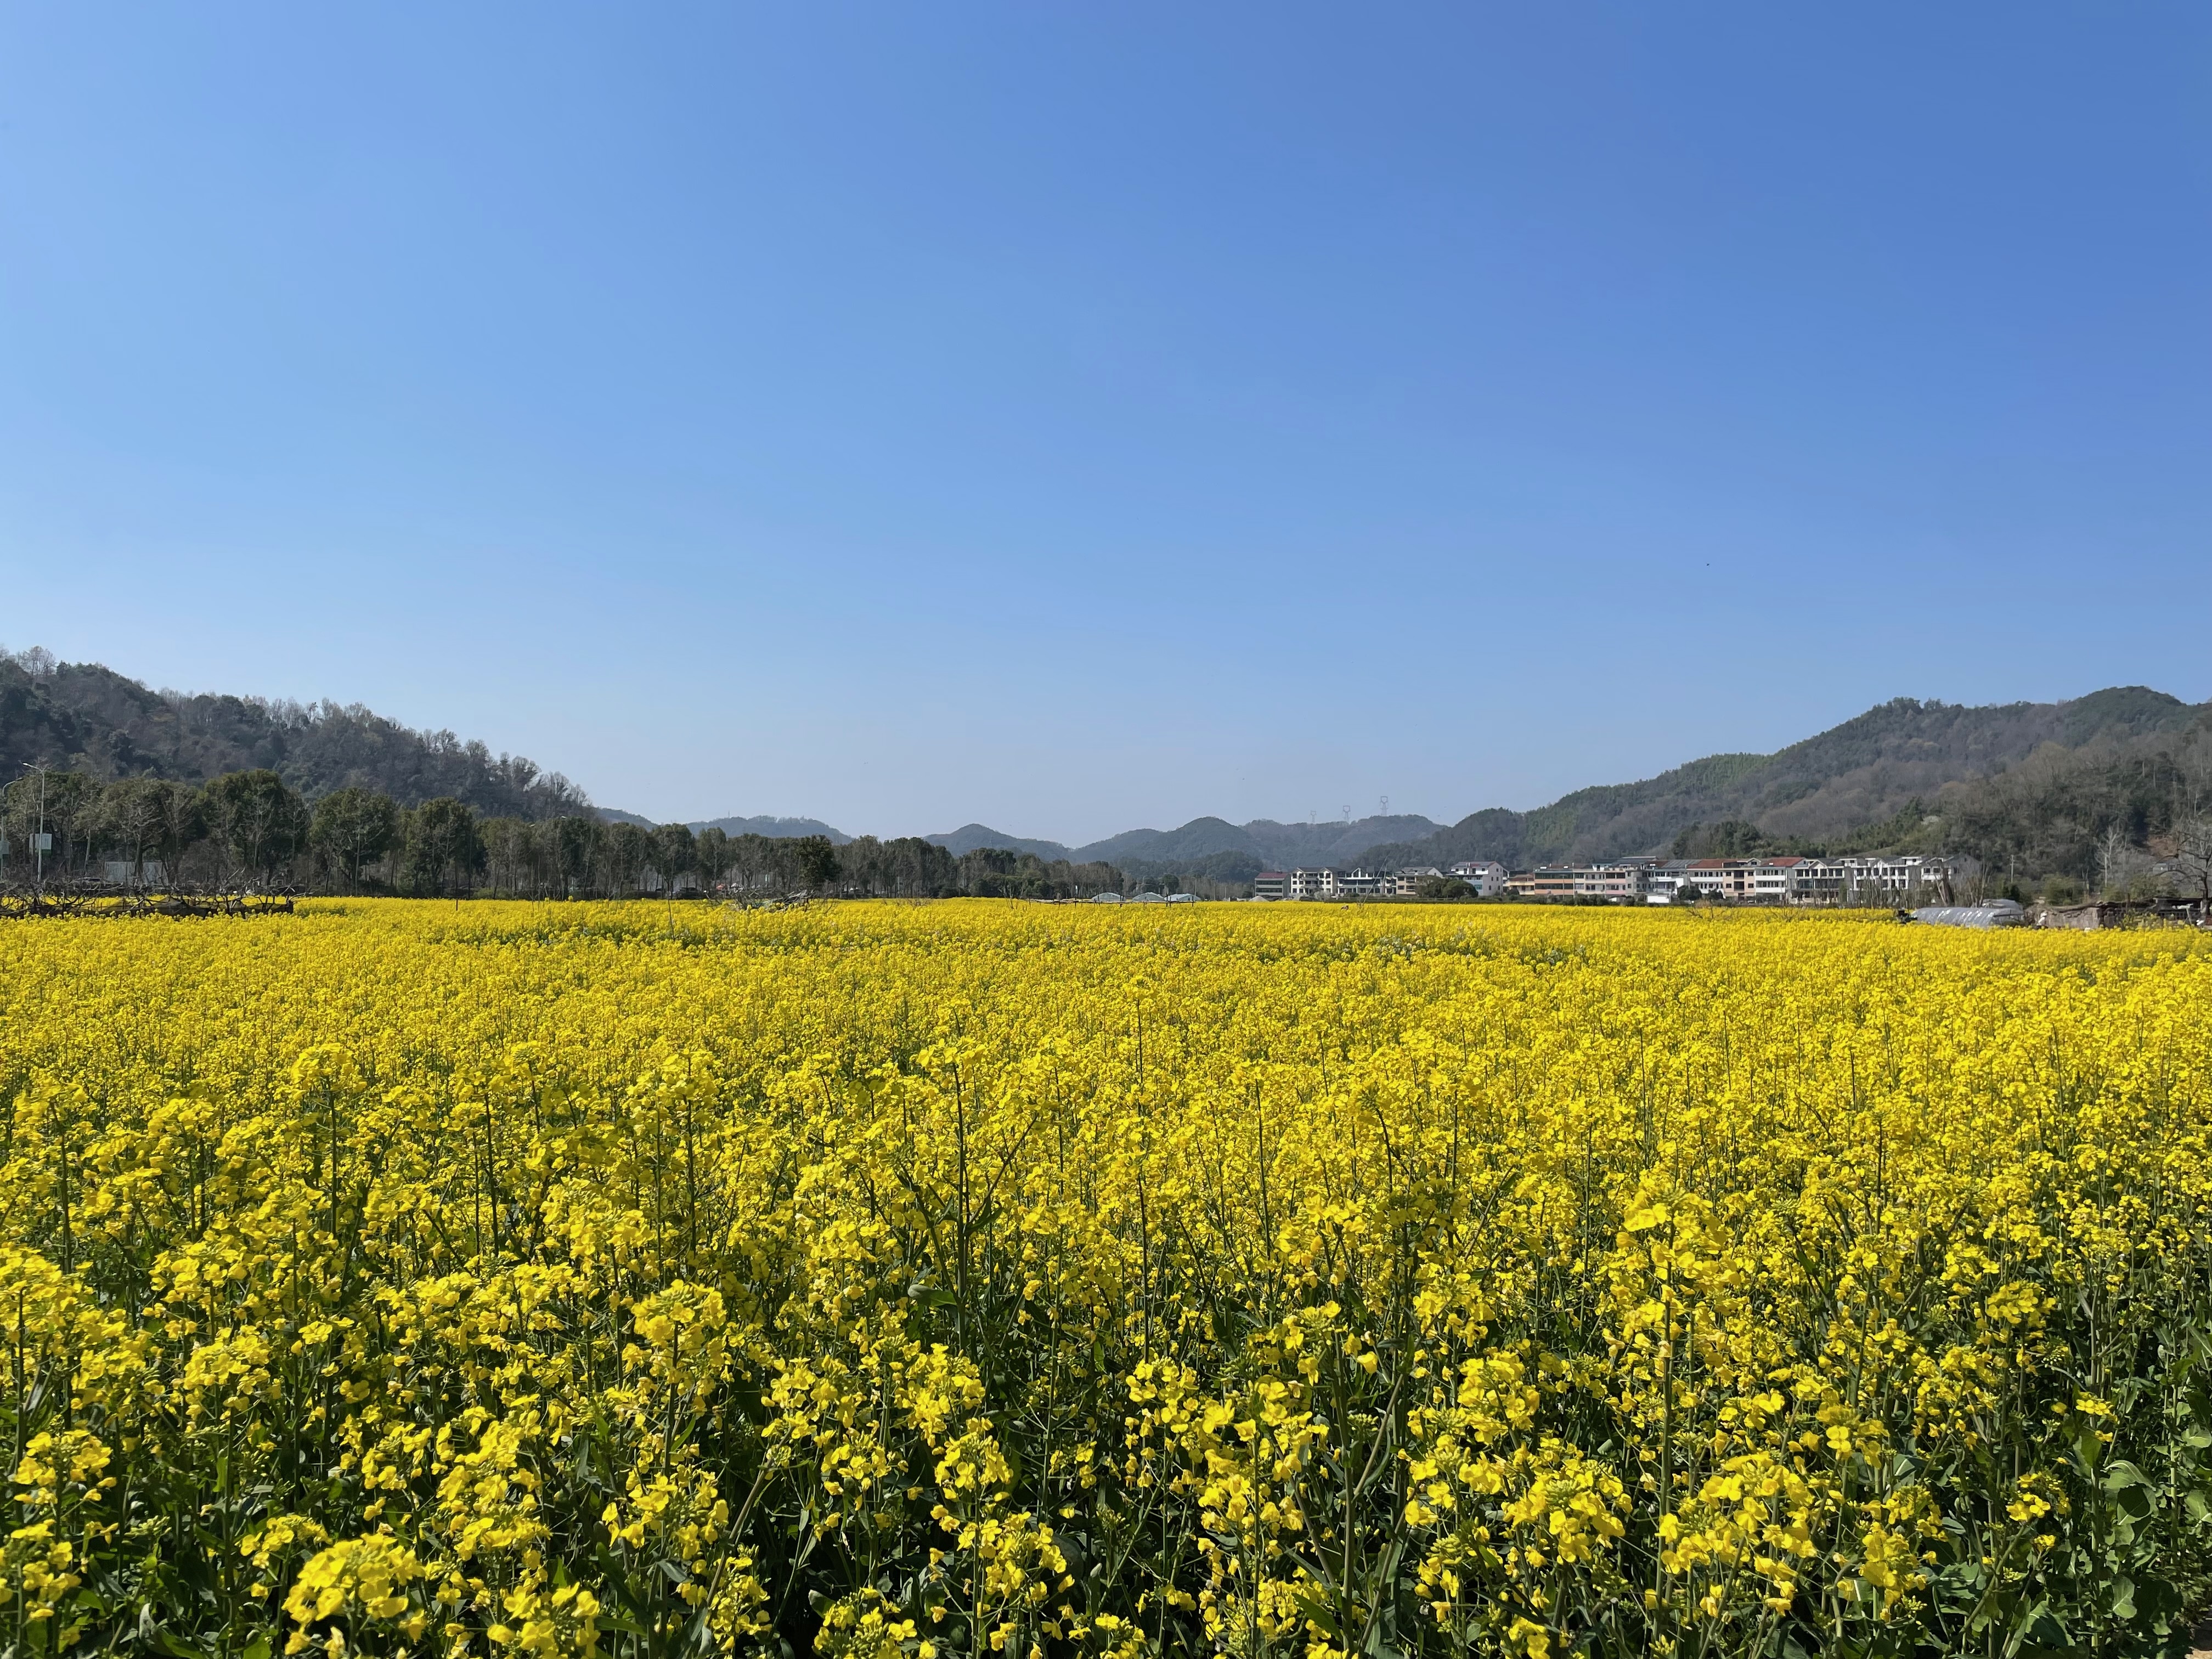
又是一年油菜花季

本周观影

  • 准备看《哈姆奈特 Hamnet (2025)》

本周阅读

  • 《House of Huawei: The Secret History of China's Most Powerful Company》:慢慢读,目前看类似任的传记。
  • 《量子迷宫》:好看好读,只是对于量子物理不懂,但是不影响阅读。
  • 《安东尼·波顿的成功投资》:读了一阵子了,我记得是前面几章有价值,后面更多是从基金管理者角度去如何考察公司等等,不太适合个人投资者,我还会重新再看的。

本周播客

  • 听了不少,但是没印象深刻的

本周胡思乱想

  • 突然意识到人类可能要迈入一种超级无聊的物理现实中去(科技和 AI 的发展,是不是无趣的会泛滥?),如果面对这种超级无聊,一定得靠自己和人类自身不断的进化。
  • 当你不喜欢一个组织/公司的,你能怎么办?工作想明白就行,虽然时不时郁闷一下是当然的,但是这个一定不能是长期的一个状态,要么另找地方,要么就是认清现实,早点找其他出路;早点找其他出路,每天都琢磨琢磨,阿里有句土话“念念不忘,必有回响”,响不响先不说,念念不忘是一定要的;多赚工资一定是最容易的那条路,比起自己折腾以及投资理财有收入,但是后两者也是不可或缺的。
  • 昨天(周二)白天处理完团队同学的事情,也算了解一桩事情,希望对方一切顺利;晚上参加了管理层的聚餐,也还算不错,但是后续公司是要出大问题了,希望不是我预设的那样,但目前的确是个不好的趋势,异常不好。
  • 每天只打开一次 feedly/x/telegram,够了,其他时间就是多消化和输出,不要 FOMO。

本周文章

又到了公司的绩效季,看到 Jean 分享了这个,linkedin 上,其实还没提一条,关于裙带关系以及内部的政治,所以大部分公司外面看着光鲜,其实都是“精致的草台班子”。

https://www.linkedin.com/feed/update/urn:li:activity:7430640803737403392/


Here's the truth about performance reviews:
* Most companies don't reward performance. They reward performance theater.
* The person who says the meeting was great beats the person who says it wasted an hour.
* The person who agrees with bad ideas beats the person who prevents disasters.
* You think you're measuring contribution. You're measuring conformity.
* And your best people? They've already figured out the game.
* They're just deciding whether to play it or find somewhere that values truth over comfort.

卡比正在吞噬 Context Engineering,下一步是 Codebase Engineering 


原文来自 Amap Nicolay Gerold:Kirby Is Eating Context Engineering,大模型演进不只是模型本身,还包括类似目前的上下文工程,结合过去看到的文章,对于构建 Agent 的思考,更多的利用一直演进变化的大模型能力是需要在工程上考虑的事情,好多“补丁”逐渐是被废弃的,但是新问题会持续出现(“So yes, we delete aggressively. But the frontier never disappears — it just moves. There is always something at the edge of LLM capability that still needs to be built.”)。


這篇文章涵蓋面很廣: 從 context rot 的本質、使用者端的 context engineering 手法、到模型如何吞噬這些手法、再到 codebase engineering 的轉向。小編覺得最有價值的洞見是那句話: 「前沿永遠不會消失,它只是移動。」你今天精心設計的 context 管理策略,明天可能被模型內化了——但新的邊界問題又會浮現,而那才是值得投入的地方。

配置系统:从幻梦到初醒

如何完善配置管理,结合系统和组织管理的流程和审计等需求?文章谈了很多,包括市场上流行的系统,开源的或商业的,留着做个参考。

Building a modern lakehouse architecture: Yggdrasil Gaming’s journey from BigQuery to AWS

工作需要还是持续学习 AWS 想过的技术和架构,而且 AWS 通过其博客持续宣传技术和方案方面,做的真的很好;这个文章本身,提到了 AWS 技术和一些开源技术的结合,比如:CDC 通过 Debezium 以及用 dbt 结合 Athena 实现数据转换,通过 Argo Workflows 实现调度,而不用 Airflow 和 Glue 等。


The migration followed a phased approach:
* Establish lakehouse foundation – Set up Apache Iceberg-based architecture with Amazon S3 with AWS Glue Data Catalog
* Implement real-time data ingestion – Deploy Debezium connectors for real-time change data capture from EKS and Google Kubernetes Engine (GKE) clusters
* Migrate processing pipelines – Re-system ETL pipelines using AWS Lambda, and legacy data applications re-systemed on Amazon EMR
* Modernizing the transformation layer – Implement dbt with Amazon Athena for modular, reusable models
* Enable governance – Configure AWS Lake Formation for comprehensive data governance

GNU and the AI reimplementations

AI 不是毒药,也不是开源腐化的助推剂,开源是否变坏或更好,其实不是 AI 的问题,更多是社区的问题,正面看,开源也许可以走的更好,在 AI 助推下,只要还有一帮有热情和仇恨自己日常工作的人在(我自己个人就是,也想在开源方面有所贡献,但是从来没做到过,也许 AI 来了对我是个更好的机会)。


Many passionate individuals write open source because they hate their day job, and want to make something they love, or they write open source because they want to be part of something bigger than economic interests. A lot of open source software is either written in the free time, or with severe constraints on the amount of people that are allocated for the project, or - even worse - with limiting conditions imposed by the companies paying for the developments. Now that code is every day less important than ideas, open source can be strongly accelerated by AI. The four hours allocated over the weekend will bring 10x the fruits, in the right hands (AI coding is not for everybody, as good coding and design is not for everybody).

Before AI, we witnessed the commodification of software: less quality, focus only on the money, no care whatsoever for minimalism and respect for resources: just piles of mostly broken bloat. More hardware power, more bloat, less care. It was already going very badly. It is not obvious nor automatic that AI will make it worse, and the ability to reimplement other software systems is part of a bigger picture that may restore some interest and sanity in our field.

https://x.com/Manjusaka_Lee/status/2031099290622505221
by Manjusaka

这种方式我的理解只是通过 skill 和 LLM 把 SRE 过去的能力和沉淀,揉进 LLM 去,而不是有实际的提升,更多还是需要考虑如何利用好 LLM 和 Agent 实现更多的自动化和智能化。


提炼 skill 将会成为 SRE 工作中很重要的一部分

对于一些常见的高风险事情,一些符合团队当前的最佳实践,对于一些事故通用的反思与积累。SRE 将会比业务团队有着更为敏锐的嗅觉。所以沉淀 skill 以及围绕 LLM 做更好的基建,将会成为 SRE 核心的一个工作

将传统的“saka,我这有个模型要上”变化成为通用的 skill,在团队内部将知识落地率以更有效更容易的方式提高,这毫无疑问是很有价值也很有挑战的一件事

或者更直白一点说,如何将事故报告更有效的转化为 skill 和 LLM 基建,将会成为衡量一个技术团队技术能力很核心的评判标准

https://x.com/lifesinger/status/2031233919258116539 by Frank 玉伯


养龙虾和带团队好像:
1、首先是要舍得发工资。比如给龙虾 Opus 4.6,立刻非常不一样。跟团队招聘要招一流人才是一个理。
2、其次是懂得授权。各种权限给到,账号密码能给的都给,各种上下文都整理好给龙虾。授权是管理的第一课。
3、然后要懂得定目标。要做啥,什么是做得好,什么是做得不好,能把目标描述清楚,说给龙虾听。龙虾拿到一个好目标,往往就能超出预期给到好结果。这和团队管理是一模一样的。
4、给予服务而不是控制。当龙虾遇到问题或寻求帮忙时,能和龙虾一起静下心来,看哪里出问题了,补充上下文或告诉龙虾怎么做。让事情能继续下去。用服务心态去帮助龙虾成长。这个点,也和带团队是一样的。
给足钱、大胆授权、定好目标、服务好过程,做到这几点,往往就是一个优秀的 Team Leader 或养虾人。
不同之处是,没找到。


https://x.com/lifesinger/status/2031975332086161424 by Frank 玉伯

活下去比啥都重要,其他都是在活下去的路上持久追求的一个过程,比如:改变世界的理想和使命愿景价值观。


早上听了创业者唐辛格的一期播客,很实在有启发。几个记忆点:

1. 融资很容易带来幻觉。很多创业者的坑都是幻觉带来的,以为是真实的,但其实通过融资,放大了人性的贪嗔痴。曾有个朋友融了 5000 万美元,很快花完了 3000 多万。意识到不对,最后用剩下的 1000 万,团队大幅减少,方向聚集到一个小点,关注现金流而不是融资故事,终于才活过来,而且后续活得很好。很多融资述事的团队,失败非常快。
2. 常识很重要,但常识也没什么用。有用的常识,是意识到自己忘了的东西。比如活下去的关键是现金流。比如五毛钱的狮子头是淀粉做的,十块钱的才是肉。尊重常识,就是不要骗自己。创业过程中,资本、自媒体等各种嘈杂会非常多,老关注会很容易骗自己。能始终清晰看见常识,不被蒙蔽,是创业过程中很重要的能力。
3. 改变世界很容易骗自己。更有机会的是小事情,两三个月就能开始赚钱获得正反馈。事小,开心,能持续去做。很多这类创业者很低调,不需要融资,也不太需要被看见。活得很好。
4. 不要遇到问题就解决问题。创业者需要谨慎选择要解决什么问题,不能什么问题都去解决,要基于资源、资金和长期兴趣。问题永远多过能解决的,过滤很重要。
5. AI native 不重要,重要的是用户愿不愿意付费。对于 AI native 的公司,收入是不是 AI 带来的无所谓,用户愿不愿意花钱比较重要。这是最简单也是最有效的判断。

总之,从唐辛格的分享里,能看到:或许创业者最重要的,是不追求宏大目标,而是能持续做自己喜欢的事,保持好奇心和学习能力,能在正循环里不断赚钱,活下去,活得好。


莫经他人苦,就别轻易说羡慕

没错,每个个体都是自我进化的过程,不用羡慕或妒忌他人,自己走的路才是真实的,他人的路你其实看不清也不会知道其是如何走过来的。


很多时候,人们之所以选择「羡慕」,是因为这样最省力。承认别人的成功来源于运气或某种不可复制的机遇,远比承认别人付出了自己无法想象的努力要容易得多。因为前者可以让自己理直气壮地原地踏步,而后者则会照出自己的懒惰与怯懦。

在这个信息极其透明的时代,我们每天都能在朋友圈、社交媒体上看到无数令人羡慕的生活片段。但这些片段往往是经过修饰的「人生高光」,那些为了支撑起这些光芒而付出的代价,都被隐藏在了阴影里。

与其把时间花在对他人的生活指点江山,或者在口头上表达那些廉价的羡慕,不如把目光收回到自己身上。每个人都有自己的时钟,也都有自己必须要跨过的坎。当我们不再轻易对别人说出「羡慕」二字时,或许说明我们已经开始真正尊重他人的付出,也开始坦然面对自己的人生路径。毕竟,生活不是过给别人看的,那些真正能让你走得长远的,永远不是瞬间的运气,而是那些没人羡慕的、枯燥且艰辛的磨炼过程。


Zen of AI Coding

这个总结的很完善,最近看的好多文章有类似的提法,未来的软件和产品研发,会如何走向?还有很多未知,但是有些是确定性的,AI/LLM/Agent 其实无法回避,只是这个过程中人的角色、软件工程管理的演化和工具变化等等问题其实都还没明确答案。


* Software development is dead
* Code is cheap
* Refactoring easy
* So is repaying technical debt
* All bugs are shallow
* Create tight feedback loops
* Any stack is your stack
* Agents are not just for coding
* The context bottleneck is in your head
* Build for a changing world
* When considering Buy vs. Build, the answer, more often, is build
* Fast rubbish is still rubbish
* Software is a liability, a product is an asset
* Moats are more expensive
* Build for agents
* Anticipate modes of failure
很快又过了一周,这周处理团队的事情,费了我很多时间和精力,以及内心的纠结,不过我现在想通了到了我现在,没必要委屈自己。

本周观影

  • 《东北警察故事3》:一如前两部,有点不一样的是这部加入了一些搞笑的元素,挺好,谢苗打的也好,还有个彪悍的丈母娘(我承认看的盗版,下回一定去电影院支持)

本周阅读

  • 《House of Huawei: The Secret History of China's Most Powerful Company》:还在看,从《2025 年度书单_卡口时代_约束如何塑造创新》的一文了解到的,目前看了一些更像是任的传。

本周播客

本周胡思乱想

  • 今天(周二)怼了团队的同学,虽然怼错了,但是我自己觉得舒心了,怼过了,后面反而好管理,好继续怼。
  • 今天(周四)又是密集沟通团队问题的一天,团队出问题,需要持续的调整,非常耗费心力、脑力和精力,需要强大的内心去克服自己和人性方面的弱点,走过去就是一片天,走不过去只能说不适合管理这个事情,people manager 这个角色我内心和实际的能力(主要是自己沟通上的韧性和柔软度来说我不合适)我其实一直不太喜欢。
  • 工作可能都没啥意思,只是份工作,我现在想明白了,所以还是要尽可能早的不工作。(和 lcq/ly 聊天谈到的,其实一直是这想法)

本周文章

800th blog post: Write that Blog!


非常好的一个技术博客,这篇文章主要谈了写博客的起源,以及为什么要写(How I write),和过程中自己的感受;我自己的体会来说,其实也类似,写可以激发更多自我的想法,以及让自己变得更有理性和结构化的思考,技巧来说就是不断累积材料同时不断写下整理自己的想法,同时不断完善成文。


I wrote about how I write here. My approach is to mess up and tidy up later. I clearly separate drafting from editing.

In this other post, I draw inspiration from a legend about a horse and an outlaw. I must be nuts! But the idea is not that crazy. Keep a file where you dump half-ideas and half-written text. Accumulate as much writing as possible as a braindump, and then edit them by organizing/wrangling the text around. When you have something you are happy with, put it out there and forget about it. Let go of expectations about the fruits of your labor.

Finally, follow your curiosity. No niche is too small. Write for yourself and trust that over time, people will find it. Entertain and serve yourself first. Writing itself should feel good. Try to get your dopamine hit from finishing a post and hitting publish. The more you write, the more you can write. Be intrinsically motivated. I am repeating myself, but it is worth repeating: do not hold expectations about people reading your work.

花了一个多小时认真听李录在哥大的演讲,对价值投资新的理解 从 Timberland 到彭博机,李录用亲身经历讲透了价值投资的本质

这篇文章写的很好,李录的视频也要看看(Li Lu, Columbia Business 2006 - Greenwald),看过李录给穷查理宝典写的序,段总也推荐过,写的也很好;内容主要包括几个部分:价值投资的三个核心信条,5 % 少数派的思维方式,两个真实案例,四个核心问题与分析框架,三件区分价值投资者的事情,卖出的哲学;值得反复看,做个真正的价值投资者,不要想着暴富,保持强烈的好奇心持续不断的阅读学习,珍惜每一个买入的机会(巴菲特的 打 20 个孔的理论),从 10 年的这个时间跨度看一家公司,抱着企业主的心态,在有巨大的安全边际的时候买入,卖出需要哲学 “李录说他早期的哲学是:如果你不愿意在当前价格买这只股票,就应该卖掉它。这个逻辑很干净,有一种数学上的一致性。但他说自己后来在这个观点上有了进化——某些公司实在太好,某些行业的趋势实在太确定,以至于你很难找到另一个同等质量的机会再买回来”。

我的退休计划:把无期变成有期 · BMPI

构建稳健的一个资产配置,建立长期的确定性,不投机、不做空和不用 margin,做个价值投资者。


对我而言,财务自由从来不是为了单纯的享乐或者躺平,它的本质是赎回对自己的时间、精力和劳动的定价权。

在这份计划里,重点其实并不完全在激进的收益率上,而是把几件事做扎实:
* 停止做空增长:把人力资本赚来的收入,逐步转换成具有Option Value的真正资产。
* 停止牢房升级:锁住支出膨胀,控制缺口规模。
* 寻找半退休杠杆:培养一份可靠的、不受职场裹挟的主动收入能力。
* 控制序列风险:构建一个稳健的资产配置方案,在3%的安全边际下保证现金流不断裂。
我写下这篇规划,没有立下什么豪言壮语的打算,只是为了给自己清晰地画出一份刑期表。出狱远不是终点,但至少在那之后,人生里的很多事,可以从必须做,变成我选择做。

年后上班第一周,上班总是无趣的,一年又一年,庆幸的是快了,没多少年了,我自己规划来说。

本周观影

  • 【用30天探索5个火山岛 ep.2】 地球上最像火星的地方 | 兰萨罗特岛:https://www.youtube.com/watch?v=sPc-4pcfRHM,博主更新的很慢,这是第二个岛,但是拍的真的很好,而且有知识。

本周阅读

  • 《哲学家的最后一课》:有些沉重的
  • 《量子迷宫》:不错的一本书,还在继续阅读中

本周播客

  • 《春节六必黑》:每年必听,听完过年也就结束了
  • 《上钟了!4000点之上的心理按摩》:听了一下,发现不错,需要花时间认真听一下,思考一下其中的观点

本周胡思乱想

  • “你的目标是未来做一个优秀的产品经理和架构师。每天上网搜索别人的优秀经验,总结成文档。每隔5分钟读习一篇文档。如果文档与之前学过的类似就归到同一文档里去。” - 这么大的话题 可以依赖大模型的不断迭代吧 而且有这方面的 skills,但人的品味和判断力需要个体对于外部知识的内化;结合 ai 如何持续学习 解决认知方面的问题和负担也是个大话题。
  • 早上时间还是得聚焦,回到技术本身,而不是其他或尽可能的少牵扯其他。
  • 看大的几个方向:

    • 1)硬件方向:GPU/TPU,存储 等等
    • 2)硬件管理和供应支撑方向:数据中心,能源/电力
    • 3)大模型和 Agent 方向:大模型公司的通用大模型,垂直的 Agent。
    • AI Infra 管理这块其实我有想法的,要做大量的学习,跨度很大;通用大模型需要很多的积累,搞不定;Agent 其实最容易但可能也是最拥挤的赛道。
    • AI infra 管理指的是如何管理大规模的 AI 数据中心硬件,这个我觉得是很好的一个未来方向。
    • 当然,另外一层就是 builder,通才,从需求、设计到最后交付,端对端都能搞定,AI/LLM 适合喜欢“折腾”的人,自己有想法马上可以产出,但是需要“品味”,这个其实大部分很难,所以未来创意和产品设计是可以拿最多钱的,真正研发也许真是可有可无,当然企业是求稳,也不可能很极端;还有,就是安全合规这一块,AI 时代如何解决安全合规问题以及伦理和法理层面的问题,也是新的命题和不错的方向。

本周文章

当”平庸”变免费,什么才是创业中最昂贵的资产?

写的真好啊,什么是 AI 无法触及?什么让我们不再平庸?

花了一个多小时认真听李录在哥大的演讲,对价值投资新的理解

花时间好好读一下,粗粗看了一下,不错的文章。

好奇心周刊第25期: 如何让AI写好代码

`

  • Claude Code (Opus 4.5/4.6):它是我的“首席架构师”、“首席设计师”和“主力开发工程师”。它对现代 Web 框架(Next.js/React)的审美和交互设计理解极其深刻,在从 Gemini CLI 切换到它时便再没有变过。
  • Gemini CLI (Gemini 3):它是“初创工程师”、“文档专家”与“首席测试”。得益于它极大的上下文窗口和极低的成本,我用它来生成文档、编写单元测试,以及扫描整个代码库进行重构建议。另外,在初始项目中它完全胜任。
  • Codex (GPT-5.3):它是“问题定位专家”。当 Claude Code 陷入逻辑死循环或“自证陷阱”时,Codex 往往能以不同的推理路径提供快速的 Bug 修复方案。
  • CodeRabbit:它是“代码检视专家”。通过 PR 自动检视,它能更加全面的审查代码问题,发现被忽略的边界漏洞。
  • 通过 Git Worktree 为每个 Code Agent 分配了一个独立的工作空间(Worktree),就像在同一个办公室里给不同的员工安排了工位。它们在各自的分支上独自工作,编码、调试,最后通过 GitHub PR 汇总。这种上下文隔离的方式,避免 AI 乱改文件导致的合并冲突,让整个开发节奏井然有序。
`
    
四种工具配合着来完成产品研发,很好的总结,最后部分关于人在这个过程中的定位和角色,其实不同的人有不同的大脑,但是第一条,关于品味是一个共识,还是就是最后一条也是,利用好 AI,通过和 AI “沟通”以及人与人之间的沟通,是否要过多干涉 AI 在过程中的表现和产出,不同人有不同看法,当下我认可作者的观点,但是随着 AI 发展,也许真的没必要了。

不必用自己的认知替人规划 | So!azy

作为朋友,在对方抱怨时提供一点情绪价值或者倾听就已经足够;而作为管理者,把宝贵的资源和机会留给真正懂得它的价值、并且有强烈自我驱动力的人,才是对团队和自己最负责任的做法。认清自己的边界,尊重他人的命运,大概是我们走向成熟必须接受的一点。

写的挺好,我自己也是这个认知,职场上有交到很好的朋友,但更多的是同事关系和上下级关系,没有其他,也不要想着渡人和助人,除非对方真的值得你帮。


2025,浪潮与拧巴


其实大模型越来越强,我越来越焦虑,牛逼的人已经产出 100X,而自己的效率却没有本质变化。我仿佛看到了上个改革开放年代或者更近的所谓的移动互联网腾飞之年,有大量的人攫取了巨大的财富,仿佛是个人都能吃上所谓的时代红利,但大多数人,浪潮过后好像也没什么变化。

而这一次,AI 巨浪滚滚向前,又创造了一大波造富神话,身处其中,感觉每天都是翻天覆地的变化,各种新的产品怎么也跟踪不过来;但似乎:每一个好像都和我没什么太大的关系,我能提升效率吗?我能赚更多的钱吗?我能更快到达自由的彼岸吗?所以更大的可能性是:浪潮过后,自己什么也没得到,就像哪些在历史机遇中平平淡淡的大多数人一样。

是不是也是这个人说的感觉?我觉得就是,但是我倒没焦虑,我预期没发赶上了,但是也还没放弃。

引自:https://x.com/geekplux/status/2025426274001248349

最近 AI 发展越快,越需要慢下来的能力。读书又变得重要起来。我喜欢读,但很少读书,我很佩服已经把阅读书籍当成习惯的人。我大概在十几年前曾读到过一篇文章,大概标题是《一天不阅读十万字的人会被淘汰》当时觉得很有道理,所以我每天阅读量是很大的,但大都是非书籍。

如何阅读更多:阅读更多的8个理由和7个策略
8个理由:
1. 阅读是你的道德义务
2. 阅读是预测未来的方式
3. 阅读防止你成为功能性文盲
4. 阅读让你成为知情的公民
5. 阅读缓解你的孤独
6. 阅读可以解决你的问题
7. 阅读是与历史上最聪明的人对话
8. 所有领袖都是读者

7个策略:
1. 早上第一件事阅读
2. 每天读一页
3. 边吃边读
4. 放松时阅读
5. 保持一本 commonplace book(摘录本)
6. 反复阅读大师的作品
7. 意识到你并不太忙

完整文章见:https://ryanholiday.net/how-to-read-more/ 

学习了,我也在重新享受阅读的乐趣,实体书和 Kindle/Boox,每天都读一点,内化化自己的知识,并有持续的输出。

过年的一周,走亲戚看长辈,一年又一年,过年至于我只是一个象征意义,没有特别的感觉了,不像小时候那时候期盼可以放鞭炮,一个一个扔的那种。

本周观影

  • 没看片,《同乐者》第一季开了个头

本周阅读

  • 《如何快速了解一行业》:不错的一本书,麦肯锡前分析师写的,比较体系化,和投资有一定的关联的关系,教的还是一套方法和框架,典型的咨询方法论
  • 《九诗心》:发现不太看不下去(没啥特别的体系,特别发散,而且容易说“大词”太“浮夸”的感觉),准备先放一放

本周播客

  • 《过年六必黑》:每年初一到初六听六哥和黑叔叔(陈晓卿)唠嗑,挺有意思的

本周胡思乱想

  • 学习、思考和游戏的另一天,现在突然回顾一下,之前假期一直是处理和学习工作相关的内容多,现在反而是走在了一条新路子上,学习的是投资和 AI 相关的信息,看的书好多也是和投资相关的,工作相关性在减弱,究其原因是因为目前工作上其实本身已经很熟悉了,而且也没啥有特别多的工作内容和挑战,还有就是本身方向上来说其实我也觉得意义不大,好还是不好?从我内心来讲是希望有更多的事情和方向,但是现实往往不如我意,只能勉强做着,但是还是不要放弃对于目前外部世界和机会的追寻,特别是继续保持我的好奇心,我要做的更多是如何持续构建,而不只是学习和想。

本周文章

2025,全新旅途

真厉害,无聊履历还是自己的思考,文中提到的 PKM(个人知识管理)有参考意义,但是我一直犹豫是否用第三方工具,如:Tana,不过目前因为公司 Mac 限制,我用了 Day One,过去一段时间也一直在尝试考虑 AI Native 的学习和写作方式,作者写的也是很好的参考。

之前有提到过我使用的笔记软件是 Tana +Heptabase,但在 AI 时代下,我基本上只使用 Tana了。
* 使用自定义的 AI Command 进行扩展探索
* Bookmark 自动总结生图
* 无限递归的深入探索
* 结合 OpenClaw 调用和保存
NotenookLM
用了一年多,主要用来深度检索,比如遇到某个问题直接让 NotebookLM 自己补齐材料,然后点击生成 PPT,让自己通过这个 PPT 快速了解这个领域的 Outline,根据知识点快速建立其一个初步的框架。‘
一旦建立了框架,深入学习时的提问就有了方向。后续如果要回到 Tana 进行无限递归的深入探索,学会高效地去提问是很重要的,这样 #question supertag 反哺给自己的信息密度才够高。

老马有一个页面关于 TW 和他组织的关于软件研发未来的工作坊,同时也是敏捷软件宣言 25 周年的纪念日: https://martinfowler.com/bliki/FutureOfSoftwareDevelopment.html

同时写了几个碎片,关于不同的话题,对于 18 号那个需要仔细看看,同时也有其他人的小结:

还有也发布了一个 future of_software_development_retreat key_takeaways pdf(https://www.thoughtworks.com/content/dam/thoughtworks/documents/report/tw_future%20_of_software_development_retreat_%20key_takeaways.pdf),从八个方面做了总结。

"We kept asking the same question in every room: if AI handles the code,
where does the engineering actually go? Nobody had the same answer. But
everybody agreed the question is urgent."

“我们在每个房间里都在问同一个问题:如果 AI 负责代码,工程到底去哪儿了?没有人给出同样的答案。但大家都同意这个问题很紧急。”
  1. Where does the rigor go? 严谨性去哪里了?
  2. The middle loop: a new category of work
  3. Agent topologies and enterprise architecture
  4. Self-healing and self-improving systems
  5. The human side: roles, skills and experience
  6. Technical foundations: languages, semantics and operating systems
  7. Security, governance and the future of agile
  8. Agent swarms: beyond sequential thinking

https://annievella.com/posts/finding-comfort-in-the-uncertainty/ 摘录文中一段,如下:


I walked into that room expecting to learn from people who were further ahead. People who’d cracked the code on how to adopt AI at scale, how to restructure teams around it, how to make it work. Some of the sharpest minds in the software industry were sitting around those tables.

And nobody has it all figured out.

There is more uncertainty than certainty. About how to use AI well, what it’s really doing to productivity, how roles are shifting, what the impact will be, how things will evolve. Everyone is working it out as they go.

I actually found that to be quite comforting, in many ways. Yes, we walked away with more questions than answers, but at least we now have a shared understanding of the sorts of questions we should be asking. That might be the most valuable outcome of all.

我走进那个房间,期待向那些更领先的人学习。那些已经破解了如何大规模采用人工智能、如何围绕它重组团队、如何让它发挥作用的人。一些软件行业中最敏锐的头脑就坐在那些桌子周围。

没有人能完全搞清楚。

不确定性大于确定性。关于如何好好使用人工智能,它对生产力真正的影响,角色如何转变,其影响是什么,事情将如何发展。每个人都在边做边摸索。

实际上,在很多方面,我发现这让我感到相当安心。是的,我们带着比答案更多的问题离开了,但至少我们现在对应该问哪些问题有了共同的理解。这可能是所有中最有价值的成果。

上面这些都是对于 AI/LLM 驱动软件研发未来非常理性的思考和讨论,集合了好多业内人士的智慧,值得学习和反思,等我看完消化完,我要写篇文章梳理一下。

持续更新中

AWS re:Invent 2025 Databases breakout sessions - YouTube playlist,总共有 37 场,有一些和 AI 相关,挑选一些了对自己有帮助的(大部分都感兴趣,利用早上和白天的空闲,都看了,看了还简单做了些笔记)。

AWS 数据库主要涉及:RDS(包括 Aurora RDS),Aurora DSQL(分布式数据库),DynamoDB,DocumentDB,ElastiCache(Valkey 是主要方向),和 Neptune 等,其他的,比如:Redshift、时序数据库也不能作为主要方向。

RDS 和 Aurora DSQL

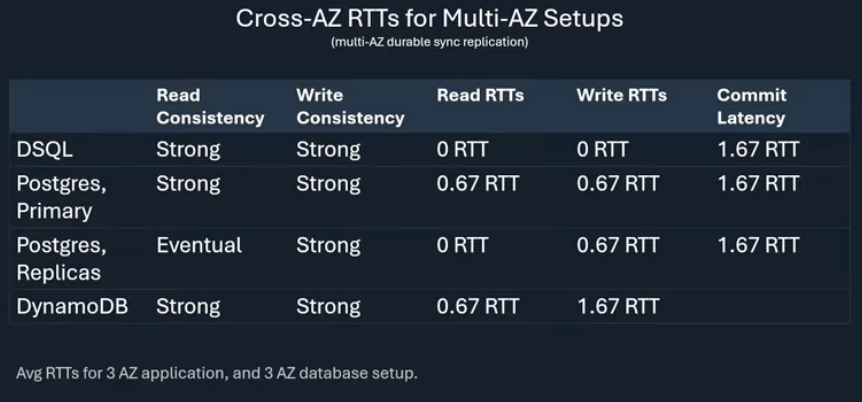
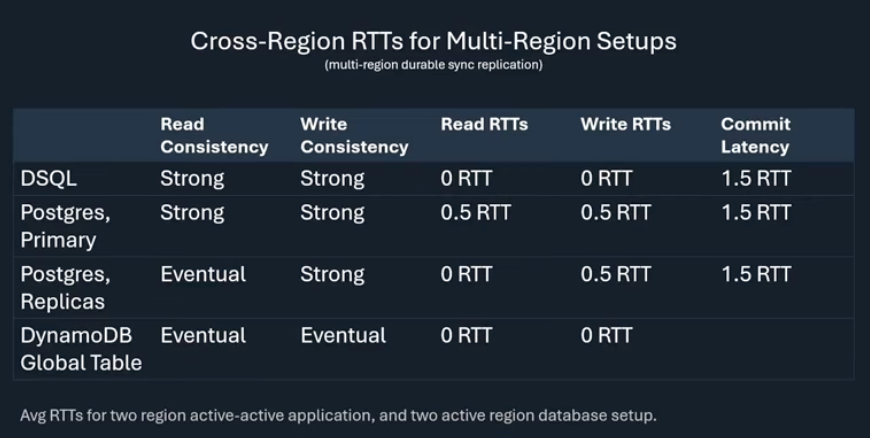
AWS re:Invent 2025 - A tale of two transactions (DAT455)

Marc Brooker 聊的一个话题,下面两张图是其主要想聊的内容,前面部分其实聊的有点无聊。

Multi AZ

Multi Region

AWS re:Invent 2025 - Amazon Aurora HA and DR design patterns for global resilience (DAT442)

AWS re:Invent 2025 - Deep dive into Amazon Aurora DSQL and its architecture (DAT439)

同一个人 Marc Bowes 参与了这两个 session;Aurora RDS 和 Aurora DSQL 是不同的设计,前者和 AWS RDS 也是不同的设计,主要体现在存储层;DSQL 是 NewSQL 分布式数据库非传统 SQL 数据库,可以实现强一致的多活读写。

Aurora RDS 应该是 AWS 持续投入的方向,DSQL 不一定有多少用户需要它(结合 2024 年阿里数据库研发同学写的文章看看 DSQL 的设计 https://baotiao.github.io/2024/12/15/aurora-2024-1.html)。

AWS re:Invent 2025 - Boost performance and reduce costs in Amazon Aurora and Amazon RDS (DAT312)

这个 session 不错,从计算、存储和备份以及 I/O 如何优化成本,通过选择合适的服务和类型,以及架构的调整。

AWS re:Invent 2025 - Revealing the northern lights: Amazon Aurora security deep dive (DAT456)

关于 Aurora 的安全机制。

AWS re:Invent 2025 - Deep dive into Amazon Aurora and its innovations (DAT441)

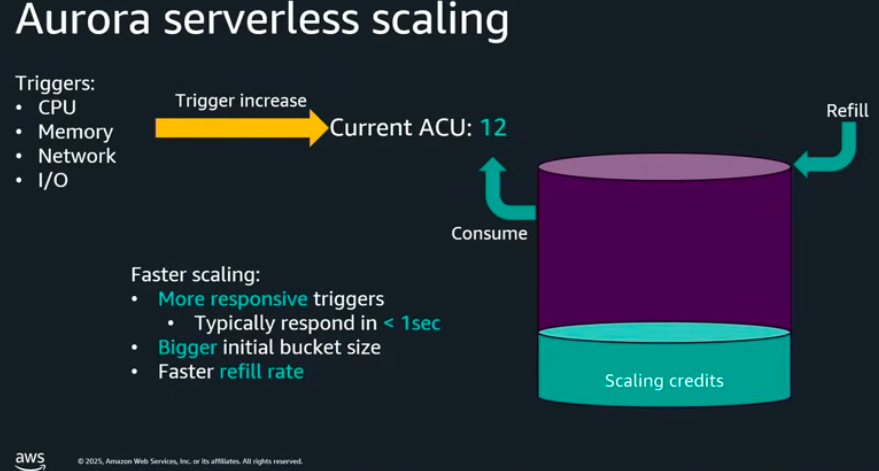
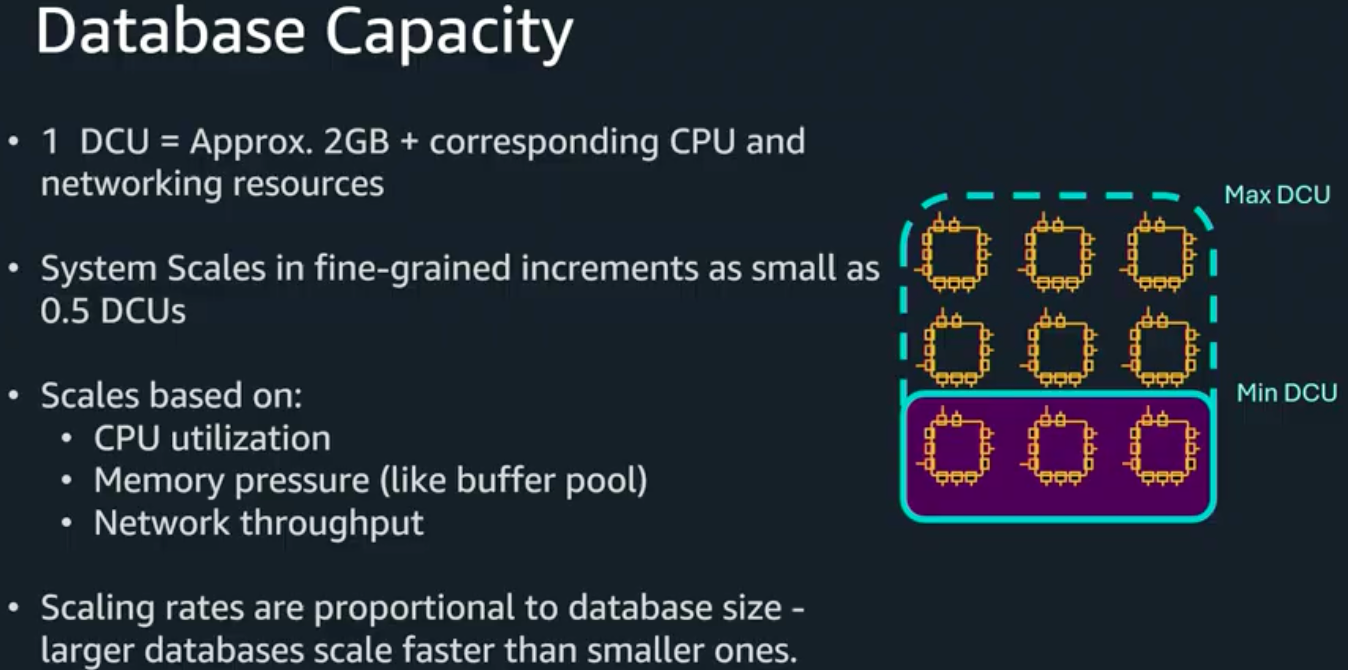
Aurora 的架构,也特别聊了 Aurora Serverless 的细节包括 scaling 的性能,如何升级打补丁,性能上优化,最后聊了 DSQL,非常好的一个 session。

Aurora serverless scaling

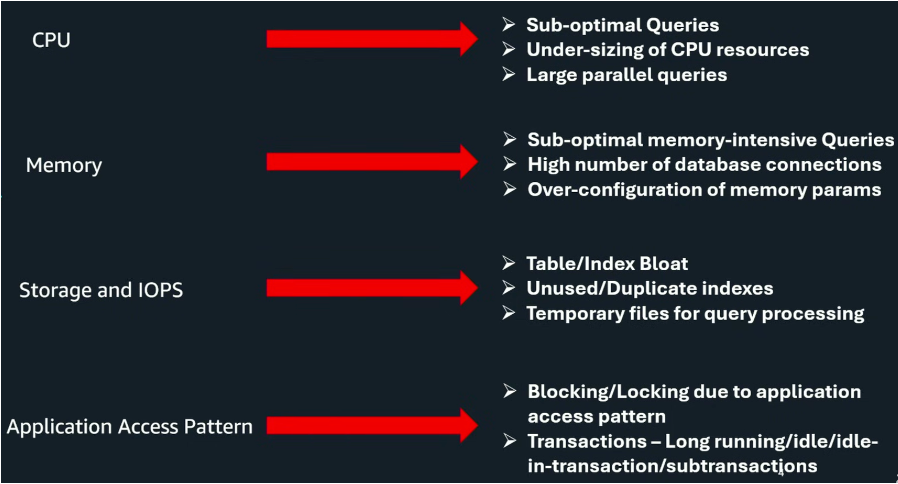
AWS re:Invent 2025 - PostgreSQL performance: Real-world workload tuning (DAT410)

有关于 PostgreSQL 性能调优。

PG perf

AWS re:Invent 2025 - Binge-worthy: Netflix's journey to Amazon Aurora at scale (DAT322)

如何第三方 PG 迁移到 Aurora PG,从迁移设计、工具开发、验证和切割展开,不错的参考(Netflix 也发了个博客文章 - Automating RDS Postgres to Aurora Postgres Migration | by Netflix Technology Blog | Feb, 2026 | Netflix TechBlog,文章里面有更详细的信息,也提到了上面 session 没提到的一些内容)。

AWS re:Invent 2025 - Amazon Aurora DSQL: A developer's perspective (DAT401)

开发者视角如何使用 DSQL,强一致,OCC 机制下需要处理事务冲突的异常。

DynamoDB

AWS re:Invent 2025 - DynamoDB: Resilience & lessons from the Oct 2025 service disruption (DAT453)
https://www.youtube.com/watch?v=YZUNNzLDWb8&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=8

2025 AWS 美东事故的剖析。

AWS re:Invent 2025 - How Samsung optimized 1.2 PB on Amazon DynamoDB with zero downtime (DAT323)

三星云的实际优化案例。

AWS re:Invent 2025 - Multi-Region strong consistency with Amazon DynamoDB global tables (DAT440)

MRSC vs. MREC 跨区域强一致性和最终一致性。

AWS re:Invent 2025 - Dive deep into Amazon DynamoDB (DAT435)

实际案例出发,讲的挺好,但是对我来说还是经验不够,理解不足,比如:第一个案例,hash 问题导致分区不工作。

AWS re:Invent 2025 - Advanced data modeling with Amazon DynamoDB (DAT414)

AWS re:Invent 2025 - Data modeling core concepts for Amazon DynamoDB (DAT311)

挺深入的,关于如何建模(不太懂 DynamoDB,为什么叫建模,而不是表的设计?),PK/SK (sort key)和 LSI/GSI(local second index,global second index) 等等等设计,以及可用性和增量备份,和 OpenSearch 等的集成,实际例子挺深入的,不错的 session。

DocumentDB

AWS re:Invent 2025 - Supercharge app intelligence using gen AI with Amazon DocumentDB (DAT313)

还是关于向量化存储和检索。

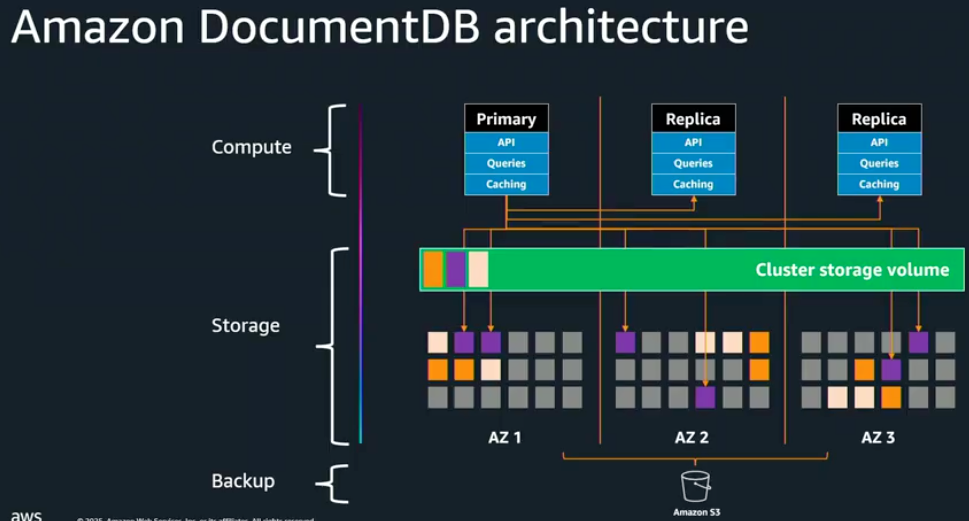
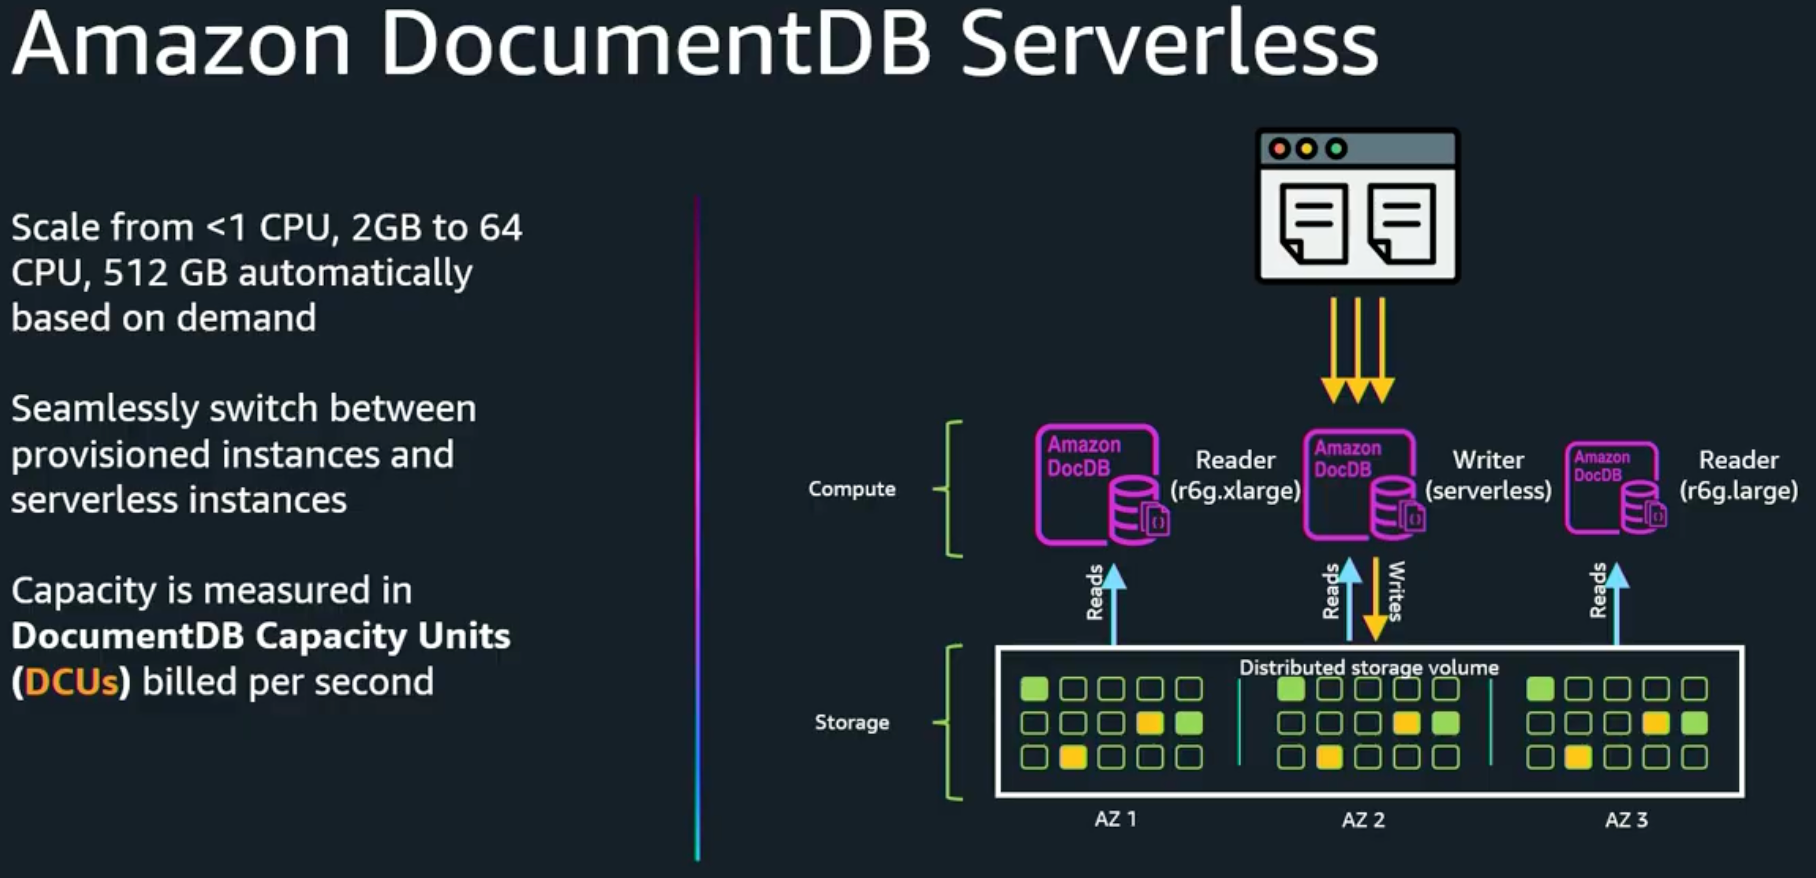
AWS re:Invent 2025 - Deep dive into Amazon DocumentDB and its innovations (DAT444)

深入 DocumentDB 架构,特性,DocumentDB Servless 架构,深入了解 DocumentDB 的一个起点。

DocumentDB architecture

DocumentDB Serverless

DocumentDB Database Capability

ElastiCache Valkey

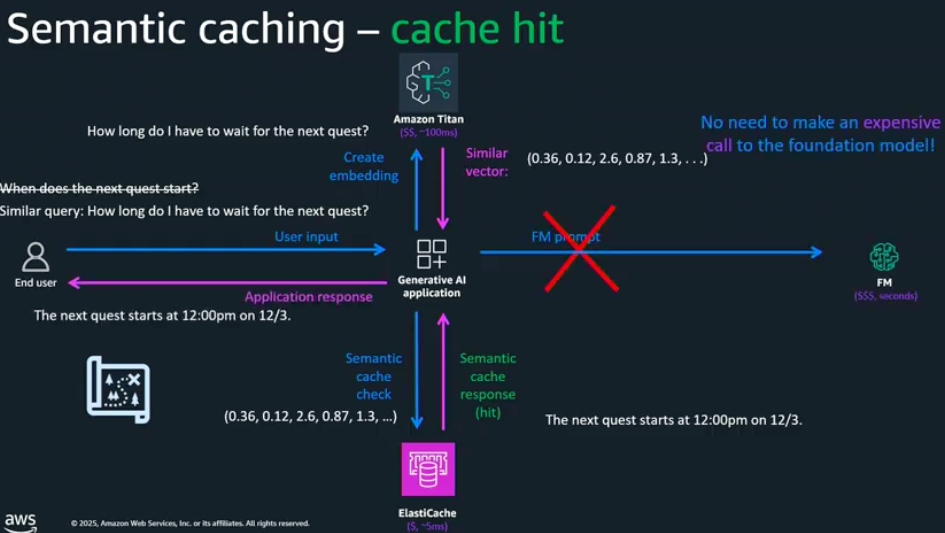
AWS re:Invent 2025 - Optimize agentic AI apps with semantic caching in Amazon ElastiCache (DAT451)

如何实现语义缓存和匹配,通过向量化存储和搜索。

[AWS re:Invent 2025 - Video sampling & search using ElastiCache & multimodal embeddings (DAT433)](https://www.youtube.com/watch?v=3Kbv_BI3NJ0&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=4]

对于视屏帧数据的多模态处理,Valkey 向量存储和检索。

AWS re:Invent 2025 - Advanced data modeling for Amazon ElastiCache (DAT438)

印象深刻的还是和 Valkey 如何存储向量和检索,semantic cacheing。

Cache hit

AWS re:Invent 2025 - Better, faster, cheaper: How Valkey is revolutionizing caching (DAT458)

撇开内容本身,看到的时候我在想作为 Director of Product Management 还能在台上游刃有余的讲产品和技术,并有足够的深度,这是我们需要学习的地方,一个技术公司需要这样。

Technical steering committee 有不少都是国人,也算厉害了;Valkey 是 Redis fork 出来的并开源了的。

聊了多线程架构

  • 给了一个火焰图分析,read/write command,特别是 write command 是栈最深的
  • main + IO thread 1, 2, ..., n: “While the core execution remains on a single thread to preserve data consistency, parsing commands and writing responses are offloaded to IO threads”
    存储和性能优化

最后是关于Roadmap - 未来会支持时序类型;不错的一个 session,有深入的内容。

[AWS re:Invent 2025 - Optimizing for high performance with Amazon ElastiCache Serverless (DAT437))(https://www.youtube.com/watch?v=fXB6wftmigU&list=PL2yQDdvlhXf9l1y_VZAm0vG2hproZMtip&index=34)

性能优化方面的。

Neptune

AWS re:Invent 2025 - Using graphs over your data lake to power generative AI applications (DAT447)

图数据库在 AI 时代越发重要了,如何结合数据湖,向量搜索、图 RAG 和记忆相关性。

其他 session

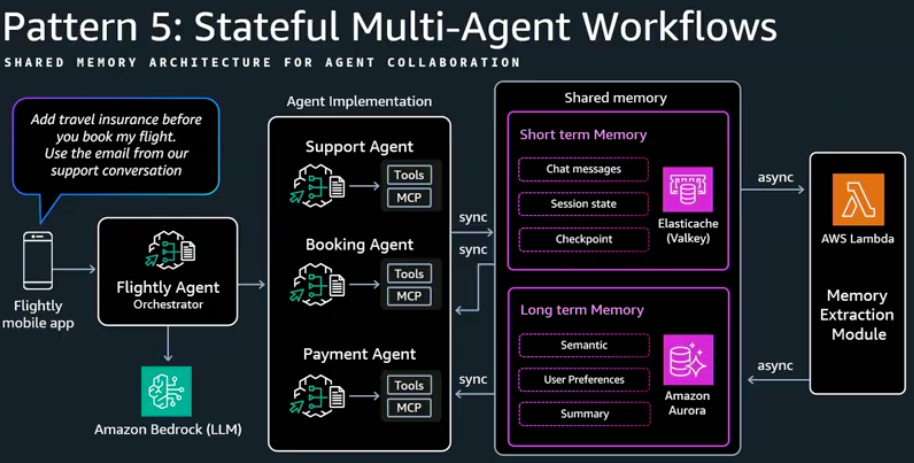
AWS re:Invent 2025 - Build serverless chatbots using Amazon ElastiCache & Aurora PostgreSQL (DAT314)

最后部分聊的 pattern,挺好的,短期和长期记忆分别存储于 Valkey 和 PG。

Pattern 5 - Multi Agent

小结

总的来说,AWS 在数据库方向除了分析型数湖仓和时序数据库方向之外,都有完整的布局和持续的投入,而且基本都提供 Serverless 选项,计费来说都是从软硬件结合为统一单位来看。